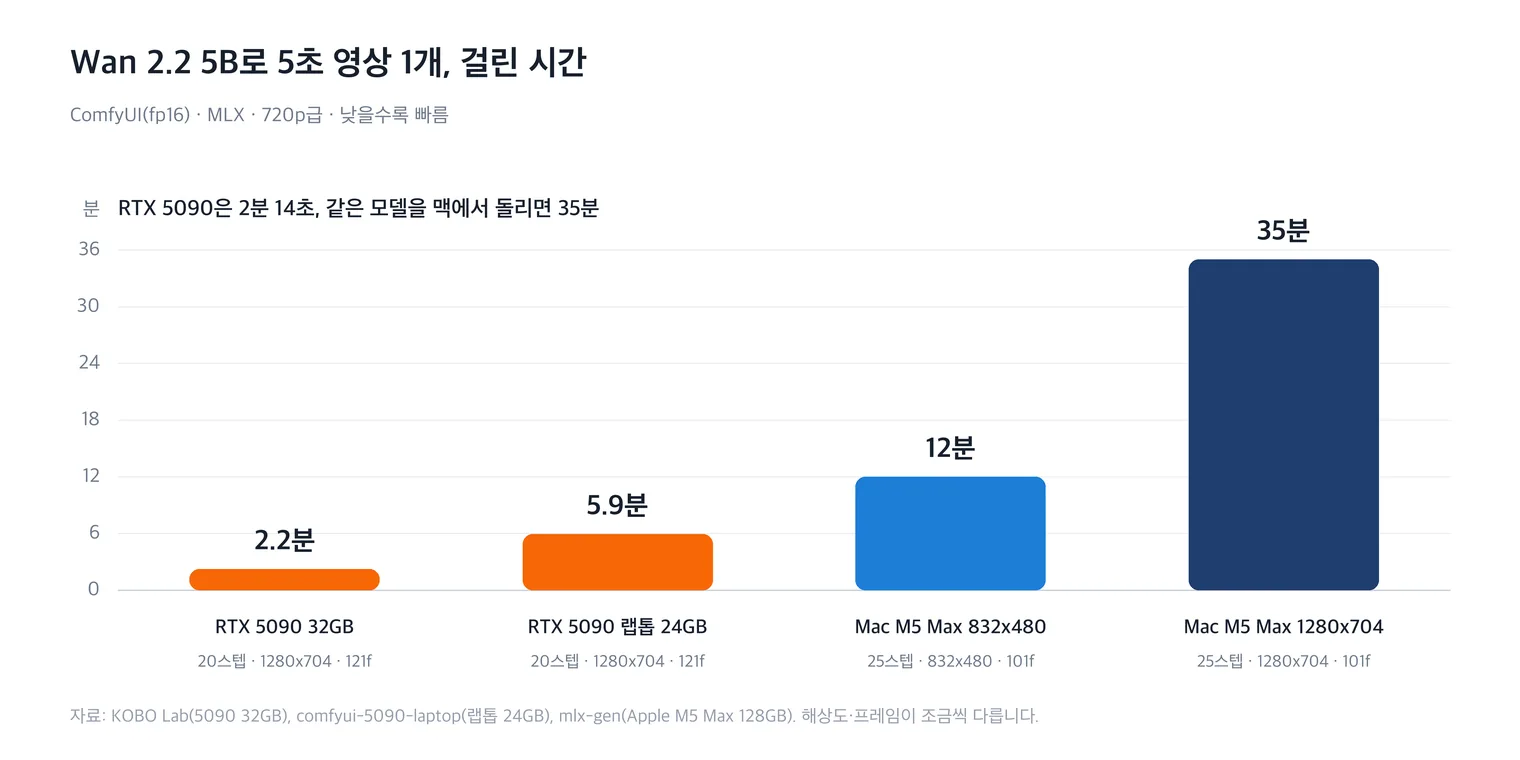
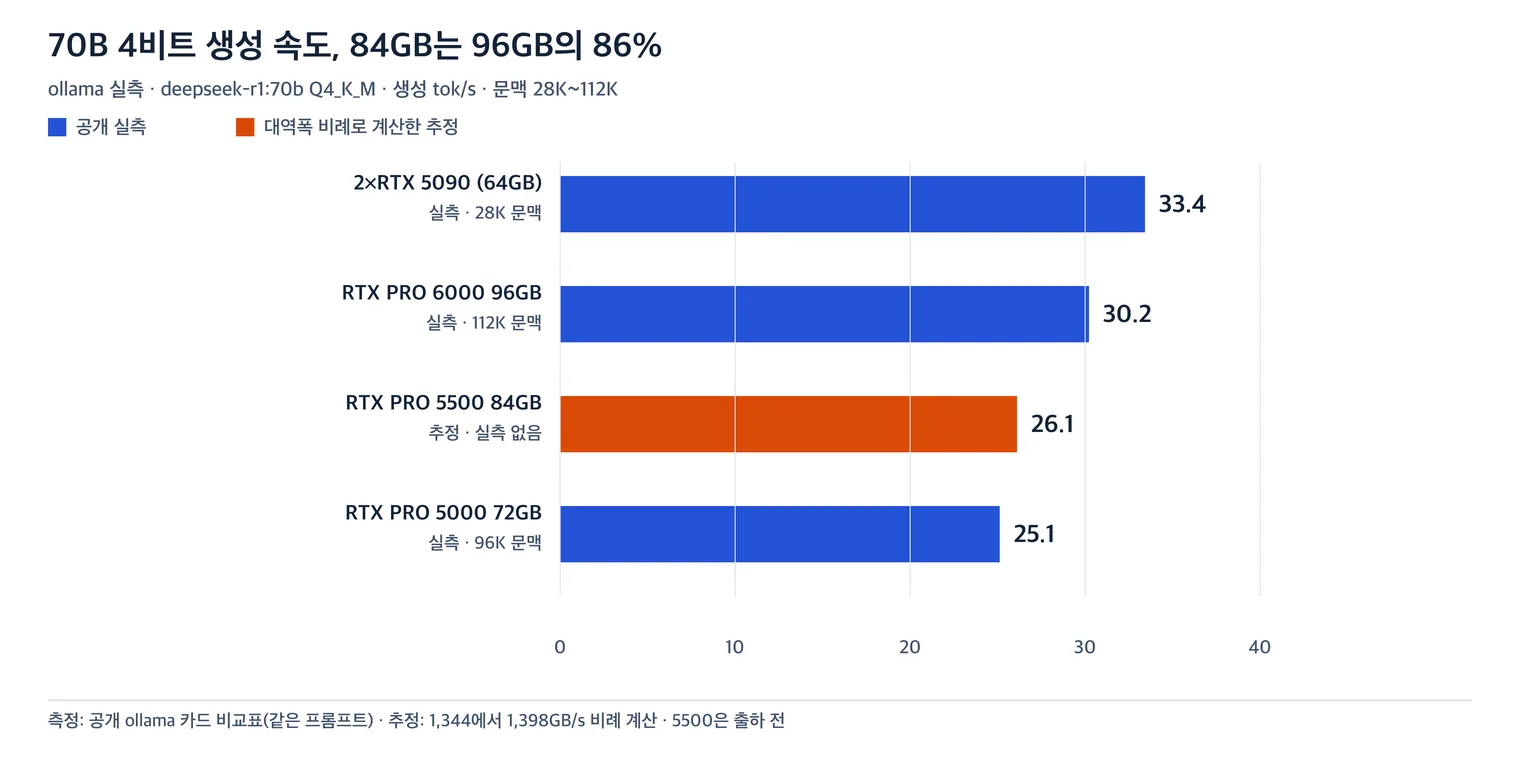
1450억 개 파라미터짜리 모델이 노트북에서 돈다. Edge0-145B와 Edge0-120B가 가중치·추론 프레임워크·배포 도구와 함께 공개됐다. 개발사가 밝힌 값은 최대 메모리 29GB, 생성 속도 초당 80토큰 이상이다. 개발사 자료의 차트에는 48GB 노트북 용량이 기준선으로 표기돼 있다. 로컬 LLM 노트북을 고르는 사람에게는 이 29GB가 새로운 기준선이 된다. 대신 조건이 셋 붙는다. 벤치마크는 개발사 내부 평가이고, 대표 배포 파일은 엔비디아 블랙웰 세대용 NVFP4이며, 라이선스는 오픈소스가 아니다. 속도와 메모리 수치는 개발사 자체 측정이다.
로컬 LLM 노트북 기준, 145B가 29GB에 들어간 이유
모델이 커지면 메모리도 같이 커져 왔다. 같은 4비트 양자화라도 7B는 3.5GB, 35B는 17.5GB, 145B는 72.5GB다. 8비트로 올리면 145B는 145GB가 된다. 노트북 한 대에 올릴 수 있는 크기가 아니다.
Edge0이 내놓은 숫자는 그 선을 29GB로 끌어내렸다. 72.5GB짜리 모델을 29GB에 억지로 밀어 넣은 것이 아니라, 처음부터 29GB만 읽고 계산하도록 모델 구조와 추론 엔진을 함께 설계했다는 쪽이다. 개발사는 클라우드 모델을 나중에 압축하거나 가지치는 방식이 아니라, 온디바이스 제약을 넣고 학습 단계부터 맞췄다고 설명한다.
계산은 10B만 — 64개 전문가가 행렬 두 개를 공유한다
구조의 핵심은 전문가 묶음이다. 64개 전문가가 큰 행렬 두 개를 공유하고, 각 전문가는 자기 차이만 담는 작은 파라미터를 따로 갖는다. 기존처럼 전문가마다 행렬 전체를 들고 있지 않으니 저장하고 옮길 가중치가 줄어든다. 145B 가운데 한 번 계산에 참여하는 것은 약 10B다.
적재는 세 층으로 나뉜다. 자주 쓰는 전문가는 그래픽카드 메모리에 상주하고, 약 40GB 규모의 전문가 라이브러리는 시스템 메모리에 두며, 약 48GB 어휘 데이터는 SSD에서 필요할 때 읽는다. 세 층의 읽기와 계산을 겹쳐 대기 시간을 줄이고, GPU가 캐시된 전문가를 계산하는 동안 CPU가 나머지를 병렬로 처리한다. 여러 후보 토큰을 한꺼번에 검증하는 투기적 디코딩도 속도에 보탠다.
개발사가 밝힌 프리필 속도는 초당 1,100토큰 이상, 소비 전력은 약 120W다. 문맥은 128K에서 256K까지 유지된다고 한다. 노트북에서 120W를 계속 쓰려면 배터리보다 어댑터 전원이 필요할 것으로 보인다.
벤치 6종 평균 72.8, 큐원3.8 플래시 넥스트는 71.7
| 모델 | 6종 평균 | 메모리 | 메모리 산출 |
|---|---|---|---|
| Edge0-145B | 72.8 | 29GB | 개발사 실측 |
| Edge0-120B | 68.9 | 29GB | 개발사 실측 |
| 큐원3.8 플래시 넥스트 | 71.7 | 약 70GB | 4비트 배포 추정 |
| 딥시크-V4-플래시-0731 | 70.1 | 약 87GB | 4비트 배포 추정 |
| 큐원3.8-27B | 66.1 | 약 18GB | 4비트 배포 추정 |
가장 가까운 비교군과는 1.1점 차다. 큐원3.8 플래시 넥스트가 71.7이고, 딥시크-V4-플래시-0731은 70.1로 2.7점, 큐원3.8-27B는 66.1로 6.7점 차다. 앞의 둘과는 폭이 작아 세대 차이라기보다 같은 급으로 보는 편이 맞다. 대신 같은 급을 절반 이하 메모리로 돌린다는 점이 이 모델의 값어치다.
세부 항목은 갈린다. 코딩·에이전트 성격의 딥스위프트 1.1에서 64.6으로 큐원3.8 플래시 넥스트 58.7, 딥시크 54.4를 앞섰고, 터미널벤치 2.1은 86.52로 세 모델(83.3·82.7·78.2)보다 높다. 반대로 상식 추론인 HLE는 35.4로 클로드 오퍼스 4.6의 40.0에 뒤진다.
숫자의 조건 — 내부 평가, NVFP4, 그리고 큐원 파생
먼저 점수의 출처다. 개발사는 Edge0과 큐원, 딥시크, 클로드 결과가 자사 내부 평가라고 밝혔다. 제3자 재현은 아직 없다. 비교군 메모리도 측정값이 아니라 4비트 표준 배포를 가정한 추정치다. 속도와 메모리는 실측, 경쟁 모델의 메모리는 추정이라는 비대칭을 감안해 읽어야 한다.
두 번째는 파일 형식이다. 허깅페이스에 올라온 대표 배포판은 NVFP4로, 엔비디아 블랙웰 세대에서 도는 형식이다. q3k 양자화도 별도 저장소로 함께 공개됐다. 개발사는 RTX 4090과 RTX 5090, 애플 M 시리즈를 1차 지원 대상으로 적었지만, 해커뉴스에서는 맥 실행 파일이 아직 없다는 지적이 나온다.
세 번째가 라이선스다. 허깅페이스 모델 카드는 라이선스를 other로 적고 있고, 베이스 모델은 Qwen/Qwen3.8-Flash-Next다. 가중치를 내려받을 수 있다는 것과 마음대로 써도 된다는 것은 다르다. 상업 이용 조건은 저장소의 라이선스 문서를 직접 읽어야 한다.
해커뉴스 반응 — 오픈소스가 아니라 오픈웨이트
해커뉴스 댓글에서는 칭찬과 지적이 갈렸다. 먼저 구조를 읽은 쪽이다. 허깅페이스 페이지에 큐원3.8 플래시 넥스트가 베이스 모델로 표시돼 있고 큐원의 별도 승인이나 저작자 표시 요건이 붙을 수 있다는 지적이 있었다. 메모리 비교가 큐원의 4비트 표준 배포를 기준으로 이뤄져 양자화 손실이 적은 쪽이 유리하게 보인다는 해석도 나왔다.
라이선스 지적은 더 직접적이다. 이건 오픈소스가 아니라 오픈웨이트라는 반응이 있었고, 오픈웨이트 기준조차 맞추기 어려울 만큼 제한적이라는 댓글이 이어졌다.
배포 형태를 걱정하는 쪽도 있다. NVFP4로 나와서 블랙웰 전용이고 구형 그래픽카드에서는 별도 양자화 배포를 써야 할 것 같으며, 표준 GGUF 파일이 아니라 여러 조각으로 흩어져 있다는 것이다. 이에 대해 개발사 블로그가 맥북을 언급했고 NVFP4 외에 q3k도 공개했다는 반론이 붙었다. 다만 M2 울트라를 벤치해 놓고 맥용 런타임은 아직 내놓지 않았다는 지적은 남는다.
시연 사례에는 회의가 섞였다. 블렌더 결과물은 인상적인데, 에이전트가 만든 결과를 사람이 다시 정리하는 시간까지 넣으면 이득이 남는지는 두고 봐야 한다는 반응이 있었다. 반대로 터미널벤치 점수는 실제 코딩 에이전트 성능과 상관이 높다며 직접 평가해 보겠다는 쪽도 있었다.
메모리 48GB급 노트북을 이미 갖고 있고 로컬 LLM을 써 봤다면, 내려받아 직접 재 볼 만하다. 개발사 차트의 기준선이 48GB 메모리 노트북이다. 적재 구조가 그래픽카드 메모리, 시스템 메모리, SSD를 함께 쓰기 때문에 카드 한 장의 메모리만 보고 판단할 수는 없다. 반대로 연산이 낮은 기기는 대상이 아니다. 개발사도 연산이 낮은 기기에서는 더 작은 모델을 쓰거나 클라우드를 쓰라고 적었다.
구매 판단은 세 줄로 줄어든다. 메모리 48GB급, NVFP4를 받는 블랙웰 세대(5090) 또는 q3k를 받는 4090, 그리고 라이선스 확인이다. 이 셋이 맞지 않으면 145B라는 숫자만 보고 하드웨어를 바꿀 이유는 없다.
원문 보기: Edge0-145B: Frontier AI Capabilities on Your Own Computer
(MANLI) 지포스 RTX 5090 Stellar OC D7 32GB 인텍앤컴퍼니
로켓배송으로 바로 받기이 포스팅은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.