LLM 테스트
기기의 특징부터 서비스의 이용 조건까지, 구매 전에 살펴볼 내용을 모았습니다.
RTX Spark 노트북 128GB, 120B 모델 초당 65토큰 — 27B는 왜 더 느린가
RTX Spark 노트북 128GB가 gpt-oss-120b를 초당 65토큰으로 돌린다. DGX Spark는 50.6토큰. 대신 27B 밀집형은 13.4토큰이다. 공개된 실측을 조건별로 정리했다.
Ryzen AI Max+ 395 128GB, 100B급 로컬 LLM은 돌아가지만 빠르진 않다
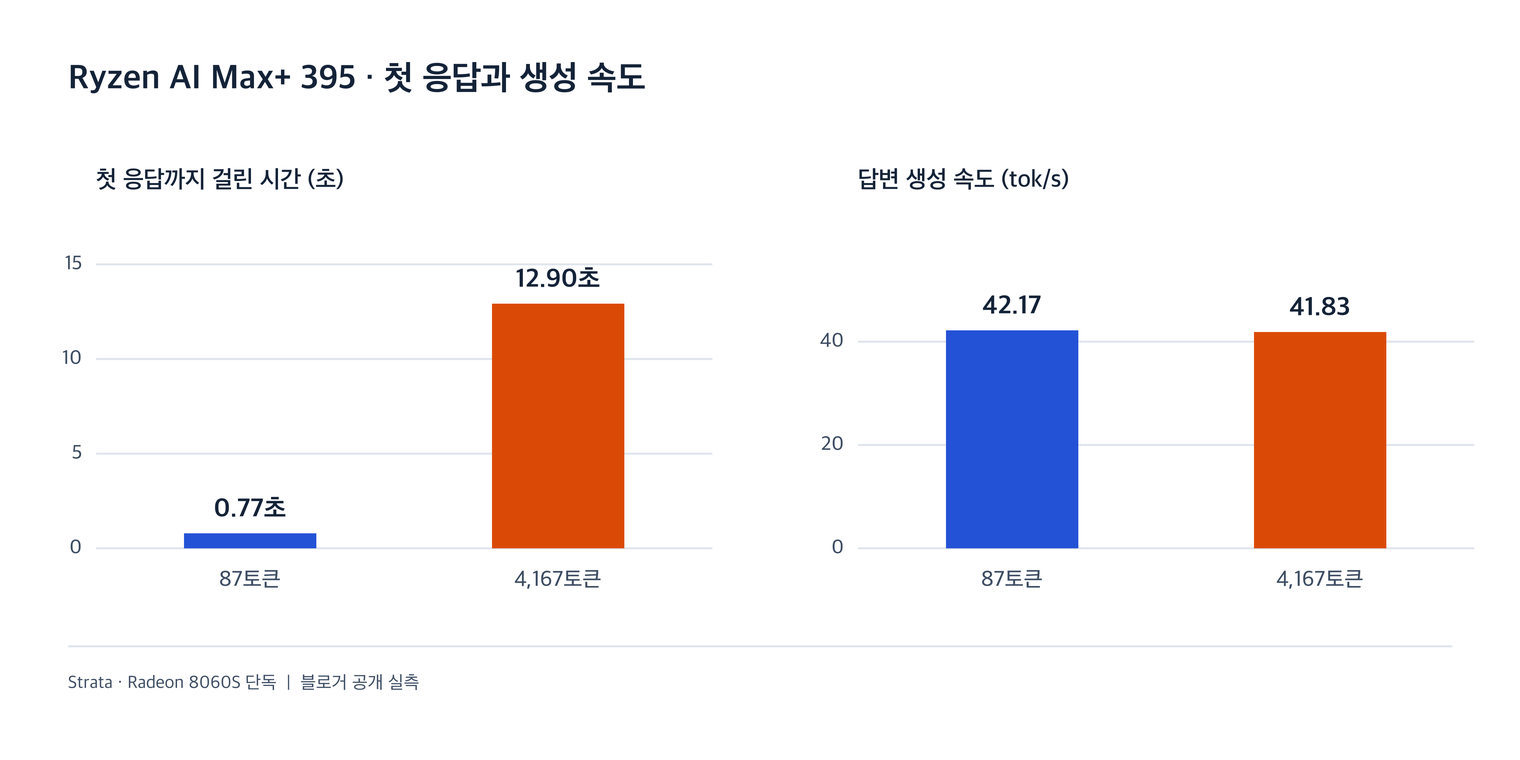
Ryzen AI Max+ 395 128GB는 100B급 모델을 한 대에 올릴 수 있는 몇 안 되는 x86 미니PC다. 대신 문맥이 길어지면 첫 응답이 13초까지 늘어난다. 큰 모델을 조용히 올려두는 용도면 맞고, 빠른 응답이 필요하면 RTX 5090 쪽이다. 128GB가 실제로 해 주는 일 이 칩의 값은 메모리에서 나온다. LPDDR5x-8000을 256bit로 묶어 최대 128GB와 256GB/s를 제공한다. 데스크톱 GPU처럼…
70B 모델 어디서 빠른가, DGX Spark와 Mac Studio M5 Ultra
70B급 모델을 매일 돌린다면 DGX Spark 128GB가 가장 무난합니다. 30B 이하라면 RTX 5090 32GB가 더 빠르고, 200B가 넘는 모델을 책상 한 대에 얹으려면 Mac Studio M5 Ultra 512GB나 RTX PRO 6000 96GB가 필요합니다. 문제는 가격입니다. DGX Spark 128GB는 $6,950, RTX PRO 6000 96GB는 국내 3,396만원입니다. 제조사 발표와 공개된 실측 기록을 같은 조건끼리 맞춰 정리했습니다. 조건이…