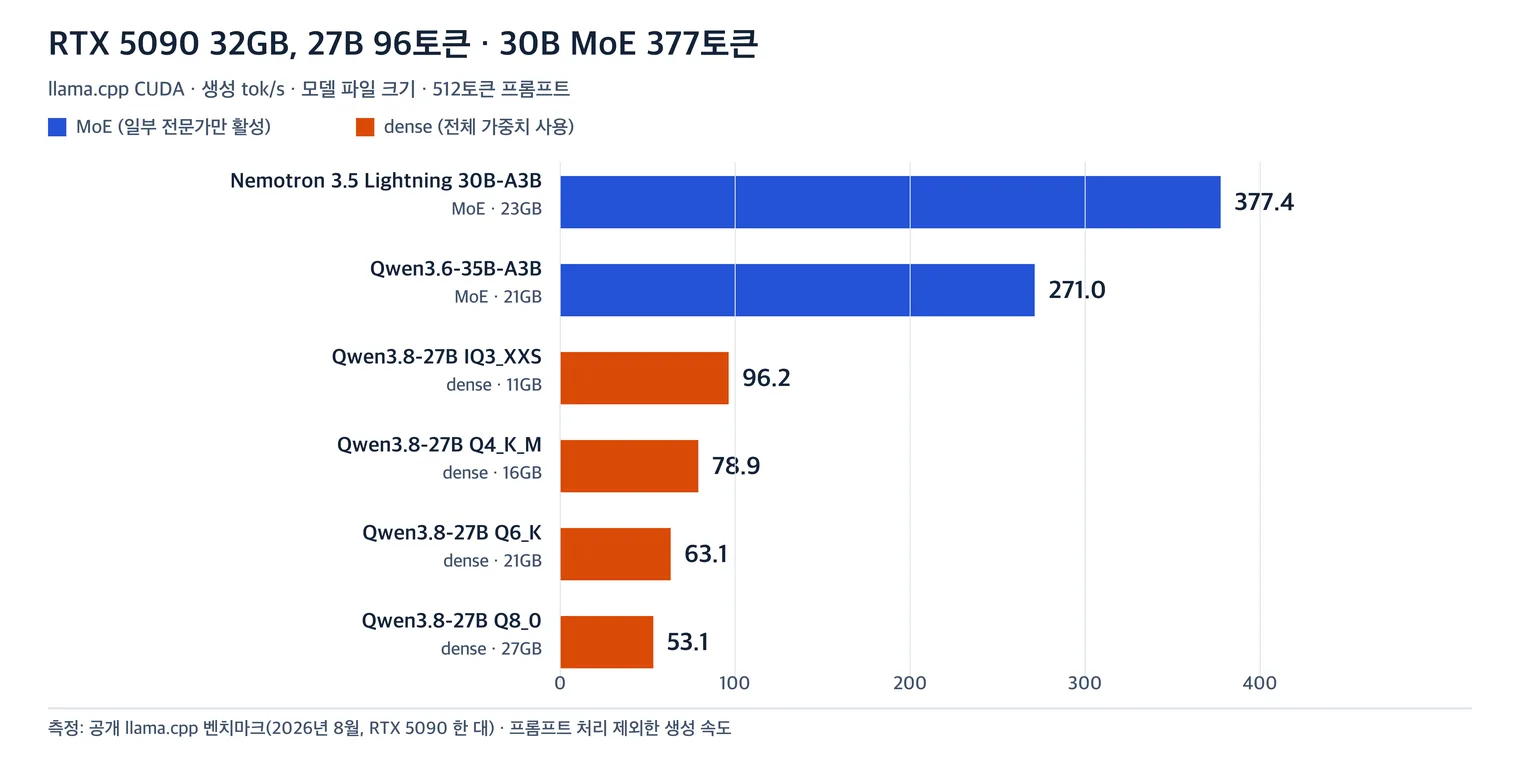
RTX 5090 32GB는 32GB 안에 들어가는 모델에서는 지금 가장 빠른 축에 드는 소비자 카드다. 27B 밀집 모델을 4비트로 올리면 초당 79토큰, 30~35B MoE 모델은 초당 271~377토큰이 나온다. 반대로 70B 밀집 모델은 4비트 파일만 41GiB라 32GB 카드에는 로드조차 되지 않는다. 122~127B MoE 모델은 전문가 일부를 시스템 메모리로 넘겨 초당 46~60토큰으로 돌아간다.
스펙은 32GB GDDR7, 대역폭 1,792GB/s, 21,760 CUDA 코어, 전력 575W다. 토큰 생성은 토큰마다 가중치를 한 번씩 읽는 작업이라, 배치 1에서는 대역폭 1,792GB/s가 사실상 생성 속도의 상한 역할을 한다. 아래 수치는 한 대의 RTX 5090에서 공개된 llama.cpp 측정이다. 라이젠 5 9600, 64GB DDR5-5600, 우분투 26.04, CUDA 12.8 조건이고, 가중치를 전부 GPU에 올린 상태에서 512토큰 프롬프트로 쟀다.
32GB에 들어가는 모델은 초당 53에서 377토큰
| 기기 | 메모리 | 모델 | 양자화 | 생성 tok/s | 프롬프트 tok/s | 필요 메모리 | 본체 가격 |
|---|---|---|---|---|---|---|---|
| RTX 5090 | 32GB GDDR7 | Nemotron 3.5 Lightning 30B-A3B | Q4_K_M | 377.4 | 11,698 | 22.8GiB | 1,075만 원~ |
| RTX 5090 | 32GB GDDR7 | Qwen3.6-35B-A3B | UD-Q4_K_M | 271.0 | 9,240 | 20.6GiB | 동일 |
| RTX 5090 | 32GB GDDR7 | Qwen3.8-27B | UD-IQ3_XXS | 96.2 | 3,944 | 11.1GiB | 동일 |
| RTX 5090 | 32GB GDDR7 | Qwen3.8-27B | Q4_K_M | 78.9 | 3,881 | 15.9GiB | 동일 |
| RTX 5090 | 32GB GDDR7 | Qwen3.8-27B | Q6_K | 63.1 | 3,223 | 21.3GiB | 동일 |
| RTX 5090 | 32GB GDDR7 | Qwen3.8-27B | Q8_0 | 53.1 | 3,834 | 27.0GiB | 동일 |
| RTX 5090 | 32GB GDDR7 | 72B 밀집 (Q4 파일) | Q4_K_M | 로드 실패 | 41.0GiB | 동일 |
프롬프트 처리 열은 512토큰을 한꺼번에 읽는 속도다. 밀집 27B가 3,223~3,944토큰인데 30~35B MoE는 9,240~11,698토큰으로 세 배 가까이 빠르다. 프롬프트 처리는 행렬 연산이라 활성 파라미터가 적은 MoE가 유리하다. 긴 문서를 먼저 읽히는 작업일수록 이 차이가 크게 느껴진다.
문맥을 늘려도 생성 속도가 크게 떨어지지 않는 것도 이 카드의 강점이다. 같은 측정에서 32K 문맥 기준 생성 속도는 Nemotron 3.5 Lightning 30B-A3B가 353.1토큰(94% 유지), Ornith 1.5 35B-A3B가 263.5토큰(87%), Qwen3.8-27B IQ3_XXS가 86.5토큰(90%)이었다. 32K까지는 87~94%를 유지했지만, 32GB를 KV 캐시와 나눠 써야 하는 카드라 문맥이 길어질수록 여유가 줄어든다는 점은 감안해야 한다.
비트를 낮추면 1.8배 빨라진다, 긴 문맥에서는 최대 33점을 잃는다
같은 Qwen3.8-27B를 양자화만 바꿔 재면 속도 차이가 선명하다. 27.0GiB Q8_0이 53.1토큰, 21.3GiB Q6_K가 63.1토큰, 15.9GiB Q4_K_M이 78.9토큰, 11.1GiB UD-IQ3_XXS가 96.2토큰이다. 파일을 2.4분의 1로 줄이면 생성 속도가 1.8배가 된다. IQ3_XXS의 측정된 최대 사용량은 12.8GiB다.
짧은 과제에서 품질 차이는 작다. 다섯 과제 평균이 Q6_K와 Q8_0 모두 93.66, Q4_K_M이 93.2, IQ3_XXS가 92.7이다. 문제는 문맥이 길어질 때다. 16K·32K·64K 문맥에서 필요한 정보를 찾아 쓰는 15개 과제에서 Q6_K는 세 구간 모두 만점이었고, IQ3_XXS는 73·67·80점이었다. 짧은 질문에는 IQ3, 긴 문서와 에이전트에는 Q6로 갈라 쓰는 이유가 여기에 있다.
추측 디코딩을 붙이면 같은 카드에서 속도가 한 번 더 오른다. Qwen3.8-27B NVFP4가 vLLM에서 68.95토큰이었는데, 모델에 들어 있는 MTP 헤드를 켜자 119.79토큰이 됐다. 1.74배다. Gemma 4 31B도 MTP를 붙여 76토큰에서 125토큰으로 올랐다. 다만 이 값은 배치 1, 짧은 출력 기준이라 긴 답변에서는 이득이 줄어든다.
70B는 41GiB, 32GB에는 안 들어간다
72B 밀집 모델의 4비트 파일은 40.98GiB다. 32GB 카드에는 올라가지 않는다. 별도 벤치마크에서도 72B 밀집 모델과 122B 모델이 32GB 한계로 로드에 실패했다. 70B급을 32GB 카드로 쓰려면 가중치 일부를 시스템 메모리로 넘기는 부분 오프로드가 필요하고, 그 순간 속도는 PCIe와 DDR 대역폭에 묶인다. R9700 두 장을 묶어 합계 60GB를 만들어야 70B가 초당 11.49토큰으로 겨우 돌았다.
대신 활성 파라미터가 적은 MoE는 넘겨서 돌아간다. Qwen3.8-Flash-Next 125B(A10B)를 2비트 73.5GiB 파일로 받아 전문가 22개 층을 CPU에 두면 생성 59.7토큰, 프롬프트 896토큰이었다. Ornith 1.5 122B-A10B는 IQ3_XXS 46.1GiB로 47.6토큰, Ling-3.0-flash 127B(활성 5.1B)는 전문가 전부를 RAM에 두고 Q3_K_M 58.3GiB로 46.0토큰이었다. 이때 GPU 사용량은 3.8GiB에 불과했다. 32GB를 다 채우지 않고도 120B급이 돌아간다.
다만 첫 토큰이 늦다. 125B 모델에 16K 프롬프트를 넣으면 첫 토큰까지 29.4초가 걸린다. 긴 답을 한 번 받는 용도로는 쓸 만하고, 짧은 요청을 자주 던지는 자동화에는 답답하다. 오프로드 비율을 바꿔가며 잰 실험에서는 GPU에 27.5GiB를 두고 초당 66토큰이 최적이었다. 32GB 상한보다 4.5GiB 아래에서 균형이 잡힌다.
RTX 5090 32GB 단종 논란, 대안은 96GB 카드
이 카드는 지금 유통이 흔들린다. 10월 중순 GB202 다이를 지포스 대신 워크스테이션 카드로 돌린다는 보도가 나왔고, 엔비디아 제프 피셔 수석부사장은 10월 17일 단종이 아니라고 해명했다. 그러면서도 엔비디아 자사 스토어에서 5090 목록이 사라졌고, 마이크로센터가 상당수 매장 표기를 취급 중단으로 바꿨다는 보도가 이어졌다. 아마존 판매가는 10월 17일 8,500달러까지 올랐고, 10월 중고 최저가는 4,795달러로 한 달 전보다 23% 올랐다.
32GB가 모자랄 때의 대안은 RTX PRO 5500 84GB다. 같은 GB202 다이에 21,760 CUDA 코어, 1,398GB/s, 600W로 대역폭은 5090보다 22% 낮다. 미국 총판 등재가는 17,999달러(11월 7일 보도)이고, 96GB인 RTX PRO 6000은 15,299달러에 등재돼 있다. 84GB 카드를 이 가격에 살 이유는 없다. 72GB 모델은 8,999달러다.
용도별로 나누면 이렇다. 30B 안쪽 모델을 빠르게 돌리는 용도라면 RTX 5090 한 장이 가장 경제적이다. 70B 밀집 모델이 필요하면 96GB 카드로 가야 하고, 122B 이상 MoE를 오래 돌리려면 통합메모리가 큰 기기가 낫다. 32GB는 빠르지만, 그 32GB 밖으로 나가는 순간 이 카드의 강점은 사라진다.
GIGABYTE GIGABYTE 지포스 RTX 5090 WINDFORCE OC D7 32GB 제이씨현
로켓배송으로 바로 받기NVIDIA NVIDIA RTX PRO 6000 Blackwell 워크스테이션 에디션 D7 96GB 서린
로켓배송으로 바로 받기이 포스팅은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.