코어세어 FlexPrime V20C는 인텔 Arc Pro B70 32GB 한 장으로 Qwen3.8-27B 4비트 모델을 초당 19.8토큰으로 돌린다. 같은 모델을 24GB 카드에 올린 워크스테이션은 적재조차 하지 못했다. 이 기기의 값은 32GB라는 용량에서 나오고, 그 용량을 실제 속도로 바꾸는 것은 카드가 아니라 소프트웨어 경로다.
미국 스토리지리뷰가 11월에 공개한 리뷰, 코어세어 제품 페이지, 카드를 직접 사서 쓴 사용자의 공개 기록을 함께 봤다. 세 기록은 측정 조건이 서로 다르다. 리뷰 장비는 판매 구성의 시스템 DDR5 32GB보다 두 배인 64GB(16GB×4)로 시험됐고, GPU가 실제로 잡은 용량은 31.9GB였다.
Arc Pro B70 32GB — 949달러 카드가 4,000달러 완제품의 이유
카드는 GDDR6 32GB를 256비트로 묶어 608GB/s를 낸다. Xe2 코어 32개와 XMX 행렬 엔진 256개, PCIe 5.0 x16, DisplayPort 2.1 네 개다. 인텔 출시가는 949달러였고, ASUS UGen 버전은 310W에 1,799유로, 네 장을 꽂으면 128GB가 된다.
본체는 24코어 코어 울트라 7 270K Plus(8P+16E, 최대 5.5GHz)에 DDR5 32GB, 1TB NVMe, 850W 80플러스 골드 파워, 360mm 수랭을 넣었다. 크기는 202×451×286mm, 무게 14kg, 부피 26.1리터다. 우분투 24.04 LTS가 기본이고 윈도 11 프로를 고를 수 있으며 보증은 3년이다. 가격은 3,999.99달러다.
27B가 30GB를 요구할 때 24GB와 32GB가 갈린다
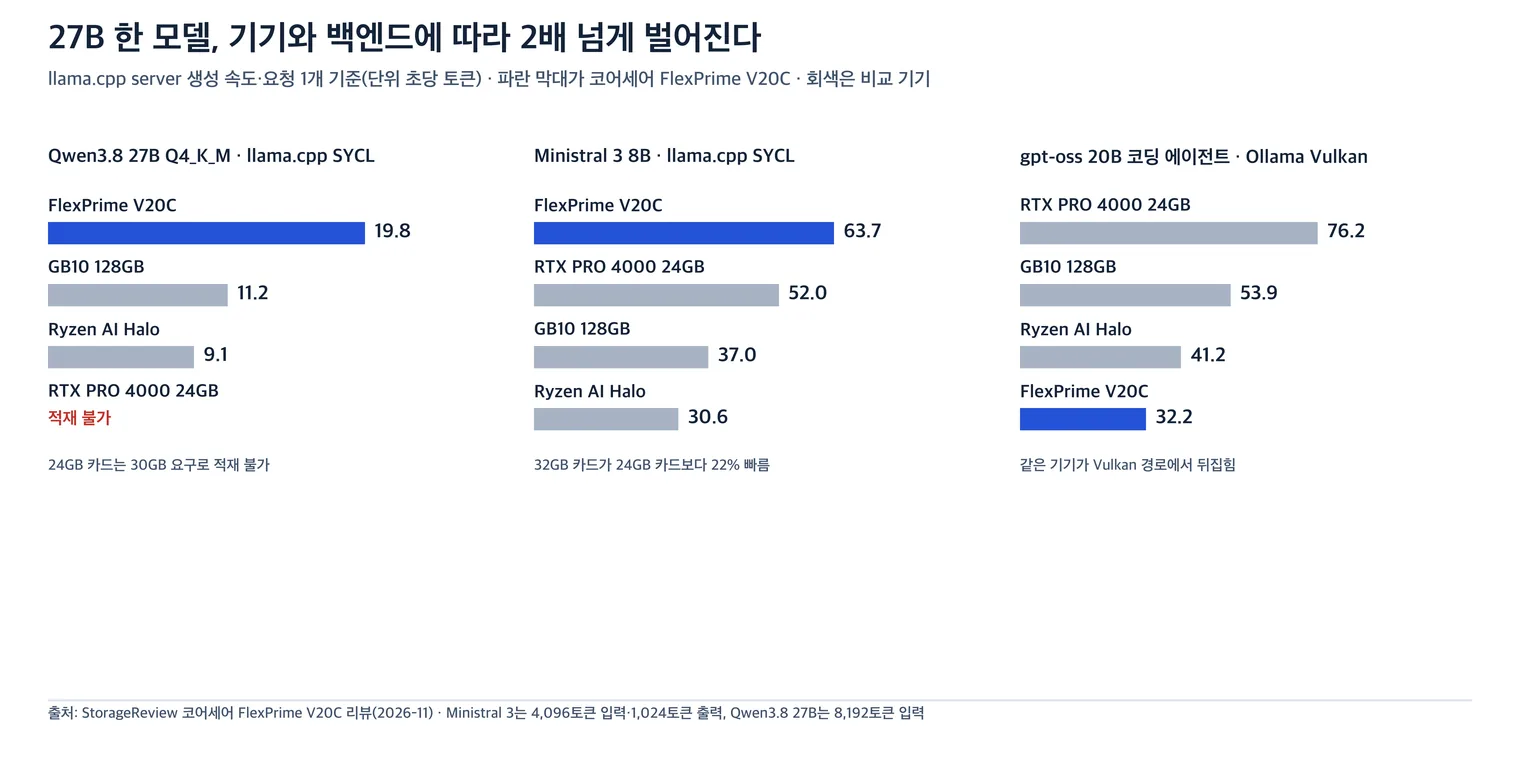
Qwen3.8-27B를 4비트(Q4_K_M)로 올리면 가중치와 요청 하나의 KV 캐시를 합쳐 30GB가 필요하다. 23.9GB를 쓰는 RTX PRO 4000 SFF는 여기서 탈락했고, 31.9GB는 요청 8개까지 버텼다. 용량 8GB 차이가 모델 하나를 통째로 가른다.
요청 하나 기준 생성 속도는 19.8토큰이다. 128GB 통합 메모리를 쓰는 GB10 기기는 11.2토큰, 라이젠 AI 할로는 9.1토큰이었다. 다만 동시 요청이 늘면 격차가 줄어 4개에서 33.5 대 27.1, 8개에서는 35.4 대 35.6으로 사실상 같아진다. 한 사람이 길게 쓰는 용도와 여러 명이 나눠 쓰는 용도는 다른 기기를 요구한다.
작은 모델에서는 32GB 카드가 24GB 카드를 앞선다. Ministral 3 8B 요청 하나가 63.7토큰으로 52.0토큰보다 22% 빠르고, 3B에서는 84.9토큰으로 80.7토큰을 넘었다. 27B의 첫 토큰은 9.0초로 GB10의 9.2초와 비슷하다. 프롬프트 처리는 비등하고 생성에서 벌어지는 구조다.
제조사 페이지는 같은 모델에 대해 약 55토큰이라고 적는다. 양자화와 엔진, 문맥 길이가 빠진 값이라 위 19.8토큰과 직접 비교할 수는 없지만, 조건을 밝힌 실측과 2.8배 차이가 나는 숫자를 그대로 인용하기도 어렵다.
같은 카드에서 백엔드가 6.8토큰과 56.5토큰을 가른다
카드를 직접 산 사용자의 공개 기록이 더 분명하다. 같은 27B 모델(Q6, 20.5GiB)을 같은 카드에 올리고 경로만 바꿨다. 기본 상태의 Ollama는 6.8토큰이었고, Mesa를 26대로 올리자 19.4토큰, KV 캐시를 f16으로 두자 33토큰이 됐다. llama.cpp를 SYCL로 직접 빌드해 돌리면 49토큰, q8_0 KV와 추측 디코딩 4단계를 붙이면 56.5토큰까지 올라간다.
| 경로 | 16K 프롬프트 | 16K 생성 | 64K 생성 |
|---|---|---|---|
| Ollama · Vulkan · Mesa 25.2 | 137 | 6.8 | 측정 없음 |
| Ollama · Vulkan · Mesa 26.2 | 324 | 19.4 | 7.8 |
| Ollama · Vulkan · Mesa 26.2 · f16 KV | 376 | 33 | 23 |
| llama.cpp SYCL · f16 KV | 908 | 49 | 40 |
| llama.cpp SYCL · q8_0 KV · 추측 디코딩 4 | 1,032 | 56.5 | 52.7 |
긴 문맥에서 차이가 더 커진다. 21만5천 토큰 프롬프트의 첫 토큰까지 Ollama·Vulkan은 1.9시간이 걸렸고 SYCL은 8.6분이었다. 리뷰도 같은 방향을 가리킨다. Ollama의 인텔 전용 경로가 모델 레이어를 카드에 하나도 올리지 못해 Vulkan으로 우회했고, 그 경로에서 gpt-oss 20B 코딩 에이전트는 32.2토큰으로 RTX PRO 4000의 76.2토큰, GB10의 53.9토큰에 뒤졌다.
이미지 생성도 같은 이유로 느리다. FLUX.2 klein 4B를 분당 4.26장 만들었는데, 24GB 카드는 11.46장, GB10은 9.96장이었다. 반대로 인텔 OpenVINO 경로를 쓰는 MLPerf Client에서는 Llama 3.1 8B가 105.4토큰, Phi-4-mini가 130.0토큰으로 이 기기에서 나온 가장 높은 값이 찍혔다. 같은 하드웨어가 어떤 런타임을 만나느냐에 따라 최고 성능과 최저 성능을 오간다.
128GB 통합 메모리 기기와는 문턱이 다르다
32GB는 27B 한 개에는 넉넉하지만 38GB를 요구하는 모델 앞에서는 멈춘다. Qwen-Image 20B의 Q8_0이 그렇고, 4비트(28GB)는 32GB 카드에도 들어가 분당 0.35장을 냈다. 38GB짜리는 128GB 통합 메모리 기기 두 대만 통과했다.
가격은 3,999.99달러다. 128GB GB10을 얹은 델 프로 맥스가 1TB 구성으로 7,521달러이니 절반 수준이고, 같은 급 통합 메모리 기기와도 비슷하거나 조금 싸다. 대신 그쪽은 32GB를 넘는 모델을 올린다는 점이 다르다.
| 기기 | 메모리 | 모델 | 양자화 | 생성 tok/s | 프롬프트 | 필요 메모리 | 본체 가격 |
|---|---|---|---|---|---|---|---|
| 코어세어 FlexPrime V20C | 31.9GB VRAM | Qwen3.8-27B | Q4_K_M | 19.8 | 9.0초/8K | 30GB | 3,999.99달러 |
| 델 프로 맥스 with GB10 | 121.6GB 통합 | Qwen3.8-27B | Q4_K_M | 11.2 | 9.2초/8K | 30GB | 7,521달러 |
| 라이젠 AI 할로 | 95.5GB 통합 | Qwen3.8-27B | Q4_K_M | 9.1 | 24.0초/8K | 30GB | |
| 델 프로 맥스 마이크로 | 23.9GB VRAM | Qwen3.8-27B | Q4_K_M | 적재 불가 | 30GB | ||
| 코어세어 FlexPrime V20C | 31.9GB VRAM | Ministral 3 8B | 미기재 | 63.7 | 1.4초/4K | 3,999.99달러 |
3,999달러에 사는 것과 포기하는 것
이 기기의 남는 값은 카드 밖에 있다. 같은 리뷰에서 LLVM 빌드가 136초로 비교군의 149·173·175초보다 빨랐고, 블렌더 몬스터 장면은 분당 330.4샘플, 7-Zip은 199.6 GIPS였다. 모델을 돌리면서 같은 책상에서 코드를 빌드하고 렌더를 뽑는 용도라면 이쪽이 실속이다. 표준 데스크톱 부품을 쓰기 때문에 메모리와 저장장치, 카드를 나중에 교체할 수 있다.
포기할 것은 분명하다. 32GB를 넘는 모델, Ollama와 이미지 생성 속도, 그리고 조용한 소음이다. 리뷰는 부하가 오갈 때 팬 회전이 불규칙하게 튀는 점과 1TB SSD의 랜덤 쓰기가 18만4천 IOPS에 그치면서 81도까지 오른 점을 지적했다.
완제품이 아니라 카드만 필요하다면 값은 더 낮아진다. 지난주에 ASRock 공식 스토어에서 1,299달러에 산 사용자는 그사이 아마존 표시가가 1,800달러가 된 것을 확인했다. 국내에서도 32GB 단일 카드로는 RTX 5090 계열을 살 수 있다. 27B 한 모델을 카드 안에 넣고 쓰는 것이 목적이라면, 32GB를 확보하는 비용과 그 카드를 굴리는 소프트웨어 경로를 함께 계산해야 한다.
ASUS ROG Astral 지포스 RTX 5090 OC D7 32GB 인텍앤컴퍼니
로켓배송으로 바로 받기이 포스팅은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.