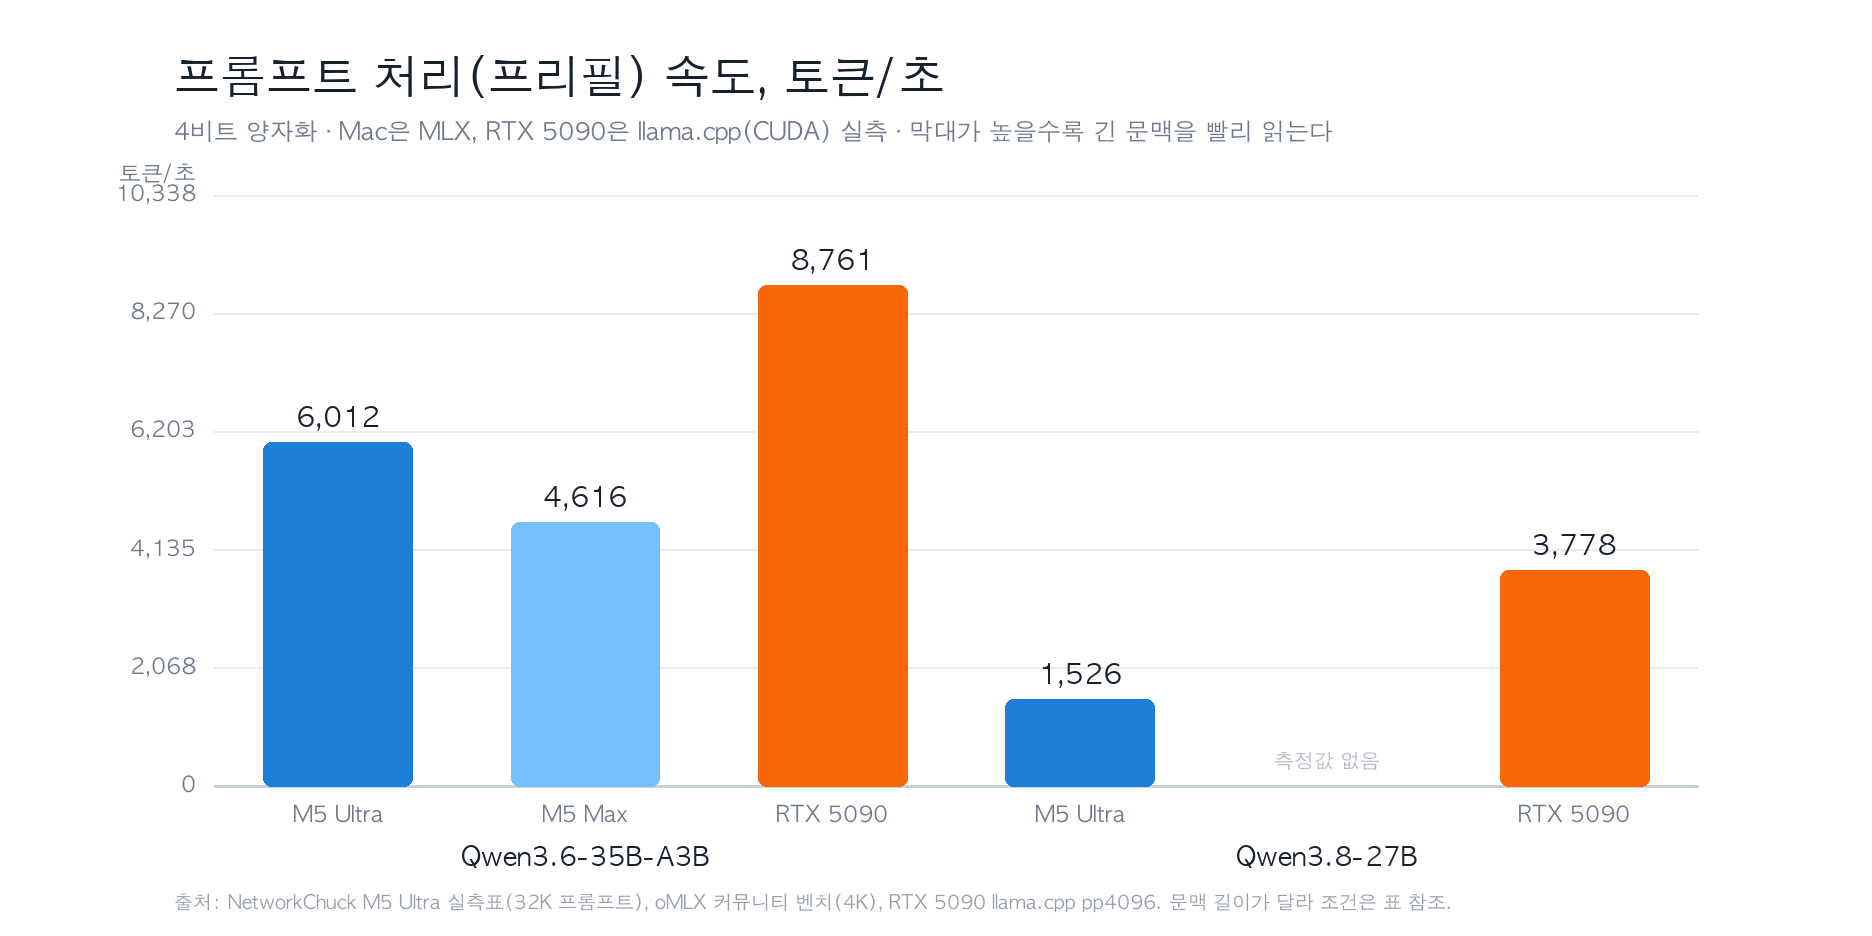
27B 모델을 4비트로 돌렸을 때, RTX 5090은 Mac Studio M5 Ultra보다 프롬프트를 2.2배 빨리 읽고 답변을 1.9배 빨리 씁니다. 질문이 512토큰으로 짧아지면 격차는 3.7배까지 벌어집니다. 반대로 100GB가 넘는 모델을 한 대에 얹어야 한다면 Mac Studio 말고는 답이 없습니다.
속도 비교에서 흔한 함정은 서로 다른 모델과 양자화를 나란히 놓는 것입니다. 이번에는 Qwen3.6-35B-A3B와 Qwen3.8-27B 두 모델로 좁히고, 모두 4비트 실측만 모았습니다. 맥은 MLX, RTX 5090은 llama.cpp(CUDA)로 각 기기에서 가장 널리 쓰는 엔진입니다. 엔진이 다르기 때문에 이 표는 하드웨어만의 차이가 아니라 지금 실제로 쓰는 조합의 차이로 읽어야 합니다.
| 작업 | 기기 | 모델·설정 | 프리필 tok/s | 생성 tok/s | 메모리 |
|---|---|---|---|---|---|
| MoE 35B | Mac Studio M5 Ultra | Qwen3.6-35B-A3B 4비트, MLX, 32K | 6,012 | 109.1 | 256GB 통합 |
| MoE 35B | MacBook Pro M5 Max | 같은 모델 4비트, oMLX, 4K | 4,616 | 122.3 | 128GB 통합 |
| MoE 35B | RTX 5090 | GGUF UD-Q4_K_M, llama.cpp, 4K 배치 | 8,761 | 271.0 | 32GB VRAM |
| Dense 27B | Mac Studio M5 Ultra | Qwen3.8-27B 4비트, MLX, 32K | 1,526 | 42.6 | 256GB 통합 |
| Dense 27B | RTX 5090 | Qwen3.8-27B Q4_K_M, llama.cpp, 4K 배치 | 3,778 | 78.9 | 32GB VRAM |
맥의 프리필 값은 32K 프롬프트에서 첫 토큰이 나올 때까지 걸린 시간으로 계산한 값이라 요청 처리 오버헤드가 포함됩니다. RTX 5090 값은 4,096토큰 배치를 순수하게 처리한 처리량입니다. 생성 값은 맥이 128토큰 답변 기준, 5090이 128토큰 측정(tg128) 기준입니다.
읽기는 행렬 연산, 쓰기는 메모리 대역폭
프리필은 프롬프트 전체를 한 번에 밀어 넣는 단계입니다. 토큰 수천 개가 같은 가중치와 동시에 곱해지므로 병목이 연산에 걸립니다. 이 단계에서 RTX 5090은 27B 모델을 3,778 tok/s로 처리하고 Mac Studio M5 Ultra는 1,526 tok/s입니다. 조건이 달라(맥 32K, RTX 4K) 두 값을 그대로 나누면 2.5배지만, 같은 4K 기준으로 맞추면 2.2배입니다.
디코드는 토큰을 하나씩 만듭니다. 새 토큰 하나마다 가중치를 메모리에서 다시 읽어야 해서 병목이 대역폭으로 옮겨갑니다. RTX 5090은 32GB GDDR7에 1,792GB/s, Mac Studio M5 Ultra는 애플이 밝힌 1.2TB/s입니다. 대역폭 차이는 1.5배인데 생성 속도 차이는 1.9배입니다. 대역폭만으로 설명되지 않는 나머지는 커널과 엔진 성숙도에서 옵니다.
질문이 짧을수록 맥이 불리합니다
같은 27B 모델에서 프롬프트를 512토큰으로 줄이면 M5 Ultra는 1,052 tok/s, RTX 5090은 3,881 tok/s입니다. 3.7배입니다. 프롬프트가 4K로 늘면 2.2배로 줄어듭니다. 맥은 요청마다 붙는 고정 비용이 커서 짧은 작업에서 손해가 큽니다.
에이전트가 툴을 짧게 여러 번 호출하는 구조라면 이 차이가 그대로 체감됩니다. 반대로 32K짜리 문서를 한 번에 읽히는 작업은 맥도 21초대에 끝납니다. 짧은 요청을 얼마나 자주 던지느냐가 체감 속도를 가릅니다.
문맥이 길어지면 MoE에서는 격차가 줄어듭니다
35B-A3B는 토큰마다 3B 파라미터만 활성화하는 MoE 모델입니다. 4K 문맥에서 RTX 5090이 8,761 tok/s, MacBook Pro M5 Max가 4,616 tok/s로 1.9배였습니다. 그런데 16K로 늘리면 5090은 7,714 tok/s로 떨어지고 M5 Ultra는 6,012 tok/s를 유지합니다. 격차가 1.3배까지 좁혀집니다.
생성에서는 반대입니다. 같은 모델에서 RTX 5090이 271 tok/s, M5 Ultra가 109 tok/s, M5 Max가 122 tok/s로 GPU가 2.2~2.5배 앞섭니다. 긴 문맥을 읽는 속도와 답을 뽑는 속도는 서로 다른 문제라는 뜻입니다.

메모리 용량이 결론을 바꿉니다
RTX 5090의 메모리는 32GB입니다. 35B-A3B 4비트(20.6GiB)는 16K 문맥까지 들어갑니다. 120B급은 들어가지 않습니다. 전문가 레이어를 시스템 RAM으로 넘긴 MXFP4 120B 측정에서 생성 속도는 46.5 tok/s까지 떨어졌습니다. 속도가 아무리 빨라도 카드에 안 들어가면 그 속도는 없습니다.
Mac Studio M5 Ultra는 96GB부터 512GB까지 통합 메모리를 씁니다. 256GB 구성에서 122B-A10B 4비트가 65.3 tok/s로 돕니다. RTX 5090이 46.5 tok/s로 버티는 크기를, 맥은 여유 있게 담고도 조금 더 빠릅니다. 크기가 목적이면 이쪽입니다.
MacBook Pro M5 Max 128GB는 35B-A3B에서 122.3 tok/s로 RTX 5090의 절반 수준입니다. 대신 책상에 묶이지 않습니다. 같은 값을 노트북에서 낸다는 점이 이 기기의 값어치입니다.
그래서 어느 쪽을 사야 하나
70B 이하 모델을 한 대로 빠르게 돌리고 파인튜닝까지 하려면 RTX 5090입니다. 프리필과 생성 모두 2배 안팎으로 앞서고, 짧은 요청을 반복하는 작업에서는 차이가 더 벌어집니다. 전력은 575W로 잡아야 하고, 32GB를 넘는 모델은 처음부터 후보가 아닙니다.
100GB가 넘는 오픈웨이트를 4비트로 얹어 한 대에서 돌리고 싶다면 Mac Studio입니다. 느린 대신 들어갑니다. 27B급만 쓴다면 두 기기 모두 충분히 빠르므로, 이때는 속도보다 메모리와 전력, 소음으로 갈리게 됩니다.
GIGABYTE GIGABYTE 지포스 RTX 5090 WINDFORCE OC D7 32GB 제이씨현
로켓배송으로 바로 받기이 포스팅은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.
Apple 2026 맥스튜디오
로켓배송으로 바로 받기이 포스팅은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.
정리하면, 속도는 RTX 5090이고 크기는 Mac Studio입니다. 사려는 모델의 4비트 파일 크기부터 확인하고, 그 크기가 카드에 들어가는지로 먼저 갈라보시면 됩니다.
이 포스팅은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.


답글 남기기