퀄컴이 데이터센터용 추론 가속기에 넣을 HBC(High Bandwidth Compute, 근접 메모리 연산) 1세대 실리콘을 검증했다고 밝혔습니다. 샌디에이고 연구소에서 산업용 자동 테스트 장비로 메모리 읽기·쓰기 경로와 메모리 옆에서 하는 연산까지 상용 제품과 비슷한 크기에서 확인했습니다.
측정값은 두 가지입니다. 외부 LPDDR5X 대비 유효 메모리 대역폭이 18배, HBM4 규격과 비교해 와트당 대역폭이 5배 이상입니다. 전력 대비 대역폭이 이 기술의 존재 이유입니다. AI 추론은 연산보다 메모리에서 데이터를 빼오는 속도에 먼저 걸리기 때문입니다.
이 기술은 2027년 상반기 샘플링 예정인 Dragonfly AI250에 들어갑니다. 지금 컴퓨터를 사려는 사람에게는 당장 살 물건이 생긴 뉴스가 아닙니다. 대신 로컬 LLM의 속도를 가르는 것이 연산량이 아니라 메모리 대역폭이라는 사실이 데이터센터 쪽에서도 공식 의제가 됐다는 신호입니다.
메모리는 쌓는데, 그 아래에 연산을 넣었다
HBM은 DRAM 다이를 베이스 다이 위에 쌓고, 그 더미를 초광대역 버스로 프로세서에 붙입니다. 대역폭은 나오지만 CoWoS나 EMIB 같은 2.5D 패키징이 필요하고, 전력도 많이 먹습니다.
퀄컴이 HBM 대신 이 구조를 미는 이유는 성능 한 줄이 아닙니다. HBM은 대역폭을 얻는 대신 전력과 패키징 비용을 함께 사야 합니다. 대규모 추론 팜에서는 그 두 가지가 전기요금과 장비 단가로 바로 돌아옵니다.
HBC는 방향을 뒤집습니다. LPDDR5X 다이를 연산 다이 위에 직접 웨이퍼 단위로 접착합니다. 데이터가 밀리미터가 아니라 마이크로미터를 이동하니 같은 일을 하는 데 드는 에너지가 줄어듭니다. 퀄컴 데이터센터 CPU·AI 사업 총괄 제라르도 자레타는 이 차이를 “데이터를 밀리미터가 아니라 마이크로미터로 옮기는 것”이라고 설명했습니다.
부수 효과도 있습니다. 메모리 아래 다이가 연산을 상당 부분 처리하면 바깥 프로세서와 오가는 대역폭은 좁아도 됩니다. 비싼 2.5D 패키징 대신 2D 유기 기판을 쓸 여지가 생기고, HBM용 특수 DRAM 대신 LPDDR 다이를 쓰니 원가도 낮아집니다.
대신 열이 문제입니다. 메모리 아래에서 연산 다이가 돌아가면 발열이 한 곳에 몰립니다. 퀄컴은 검증에 열 특성도 포함했다고만 밝혔고 세부 수치는 공개하지 않았습니다.
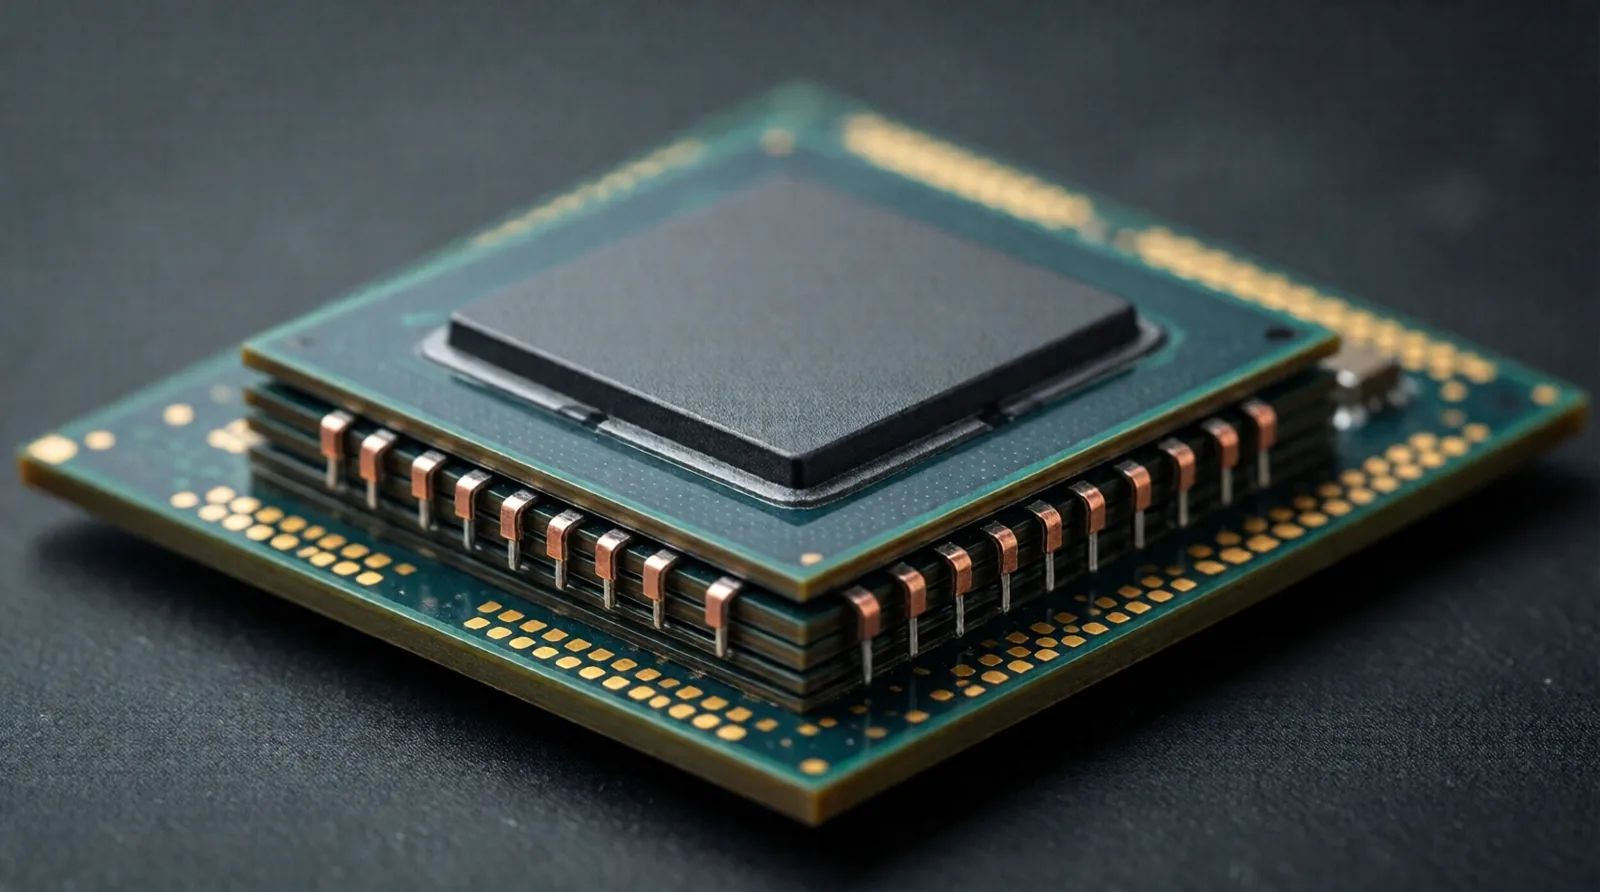
랩에서 나온 숫자: 18배와 5배
측정은 산업용 자동 테스트 장비에 무작위 가중치와 활성값을 넣는 방식으로 진행됐습니다. 결과는 LPDDR5X 대비 유효 대역폭 18배, HBM4 규격 대비 와트당 대역폭 5배 이상입니다.
숫자를 그대로 받아들이기 전에 네 가지를 봐야 합니다. 검증에 쓴 시료는 DRAM 2층이고 양산 제품은 4층입니다. 대역폭 절대값은 공개되지 않았습니다. HBM4 비교는 실제 제품끼리 잰 값이 아니라 규격에 목표 동작 조건을 맞춘 추정입니다. 퀄컴이 처음 내건 6배 목표에는 미치지 못했습니다.
제품 스펙에는 숫자가 있습니다. AI250 카드는 유효 메모리 대역폭 133TB/s로, 앞선 AI200보다 18배입니다. 액체 냉각 랙 한 대로 묶으면 시스템 메모리 38.6TB, 유효 대역폭 7.4PB/s입니다.
일정은 2027년 샘플, 2028년 다음 세대
AI200은 올해, HBC를 얹은 AI250은 2027년 상반기 고객사 샘플링입니다. 서버 CPU C1000도 2027년, 다음 세대 HBC를 쓰는 AI300은 2028년입니다.
AI250에서 HBC는 프로세서 전체가 아니라 보조 연산기로 동작합니다. 디코드 연산 대부분을 HBC 안에서 끝내고 결과만 SoC로 넘기는 구조입니다. 좁은 외부 링크가 전체 속도를 잡아먹지 않게 설계한 것입니다.
퀄컴이 칩 초기 동작 검증을 블로그와 사전 브리핑으로 공개한 것도 이례적입니다. 자레타는 “이건 평범한 칩이 아니다. 이런 걸 해낸 것이 처음”이라며 내년 양산 수율에 대한 자신감을 보이려는 자리라고 설명했습니다.
퀄컴은 HBC를 데이터센터 밖으로도 확장하겠다고 예고했습니다. Snapdragon 쪽 적용 가능성을 언급했지만 시기와 제품은 정하지 않았습니다. 노트북·태블릿용 칩에 이 구조가 들어오면 로컬 추론 판이 달라질 수 있지만, 지금 확정된 일정은 없습니다.
지금 컴퓨터를 사려는 사람에게
로컬 LLM은 토큰 하나를 만들 때마다 모델 가중치를 메모리에서 다시 읽습니다. 그래서 초당 토큰 수는 코어 수보다 메모리 대역폭에 더 크게 묶입니다. HBC가 노리는 지점이 정확히 여기입니다.
퀄컴의 기존 카드가 왜 좁았는지 보면 이해가 쉽습니다. 2024년에 나온 Cloud AI 100 Ultra는 150W에 ECC 128GB LPDDR을 달았지만 대역폭은 548GB/s입니다. 용량은 넉넉한데 대역폭이 좁아 LLM 디코드에서는 답답한 구성입니다.
용량만 보고 고르면 실패하는 이유도 여기 있습니다. 128GB를 달아도 대역폭이 좁으면 토큰이 나오는 속도는 제한되고, 32GB라도 모델이 들어가는 크기라면 대역폭이 넓은 쪽이 유리합니다. 모델이 메모리에 들어가는지와 얼마나 빨리 도는지는 다른 질문입니다.
그래서 지금 살 물건을 고르는 기준은 그대로입니다. 메모리 용량과 대역폭을 함께 봐야 하고, 대역폭이 좁으면 용량이 커도 생성 속도는 늘지 않습니다. 지금 로컬 추론을 한다면 GDDR7을 단 그래픽카드나 대역폭이 높은 통합 메모리 워크스테이션이 현실적인 선택지입니다.
HBC가 제품으로 나와도 바로 살 수 있는 형태는 아닙니다. AI250은 기업·하이퍼스케일러 샘플링부터 시작하고 가격도 공개되지 않았습니다. 이 뉴스로 바뀌는 것은 오늘의 구매 목록이 아니라 2028년 이후의 서버 구성입니다.
원문 반응
GeekNews에 옮겨진 해커뉴스 댓글에서는 먼저 “사양이 낡아 보이는 건 2024년에 나온 칩이기 때문”이라는 지적이 나왔습니다. Cirrascale 같은 클라우드 업체가 이 카드를 제공하고, 폐기된 MI50과 V100까지 다시 꺼내 쓰는 상황이라 2년 전 제품도 새 기술처럼 보인다는 것입니다.
HBC 평가는 갈립니다. 한쪽은 퀄컴이 Snapdragon X2 Elite Extreme에서 패키지 내장 3채널 메모리로 228GB/s를 내는 점을 근거로 “차세대 핵심 기술로 High Bandwidth Compute를 내세운다”고 봤습니다. 다른 쪽은 GeekNews 원문이 다룬 Cloud AI 100 Ultra를 두고 “메모리 대역폭이 M4 Max 수준이라 인상적이지 않다”고 잘랐습니다.
소비자용 컴퓨팅을 뒷전으로 미는 것 아니냐는 우려도 함께 나왔습니다. 데이터센터에 자원을 몰아주는 회사가 늘어난 지금, 이 걱정은 퀄컴만의 문제가 아닙니다.
퀄컴은 메모리 아래에 연산을 넣어 대역폭과 전력 효율을 함께 잡는 길을 열었고, 그 첫 실리콘을 랩에서 확인했습니다. 다만 시료는 2층이고 비교 기준은 규격 추정이며 제품은 2027년 샘플입니다. 지금 로컬 추론을 한다면 메모리 대역폭이 넓은 기존 하드웨어가 여전히 답입니다.
RTX5090 32G 그래픽 카드 Yeshen Super Dragon Carving
로켓배송으로 바로 받기이 포스팅은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.