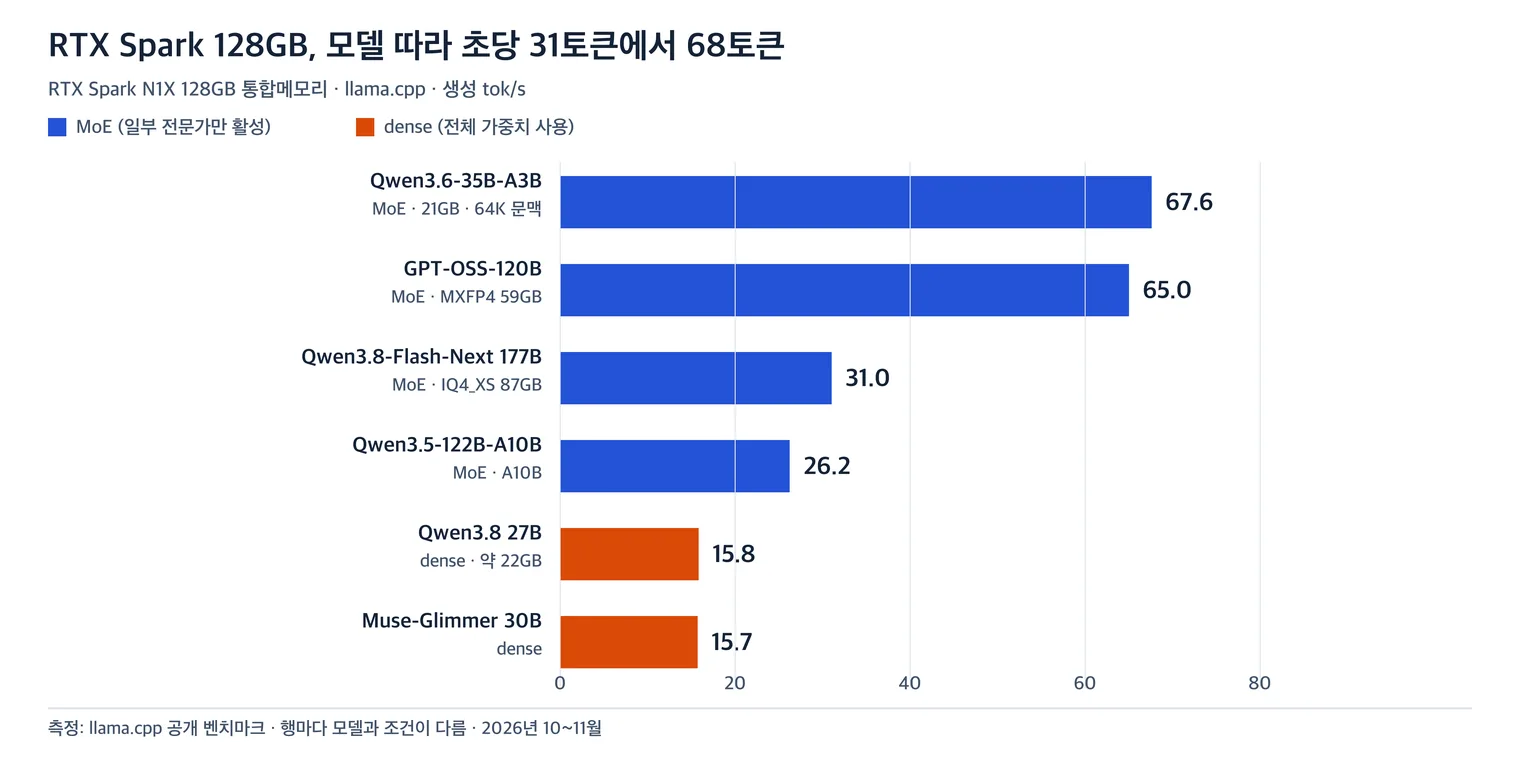
젯슨 AGX 토르는 128GB 통합메모리로 120B급 MoE 모델을 실제로 돌린다. gpt-oss 120B가 초당 41.8토큰으로 답하고, 같은 조건의 DGX Spark는 52.9토큰이다. 용량과 대역폭이 같은데 갈리는 이유는 GPU 코어 수와 전력 예산이다.
엔비디아 젯슨 AGX 토르 개발자 키트는 로봇과 차량에 넣는 모듈형 컴퓨터다. 2,560개 CUDA 코어, 14코어 Arm CPU, 128GB LPDDR5X 256비트(273GB/s), 전력 40~130W, 크기 243×112×57mm, 정가 5,499달러다. 데스크톱을 대신하려고 사는 기기는 아니다.
젯슨 AGX 토르, DGX Spark와 같은 128GB인데 왜 느린가
두 기기의 메모리는 같은 128GB LPDDR5X 256비트, 같은 273GB/s다. 다른 것은 GPU다. DGX Spark의 GB10은 CUDA 코어가 6,144개로 토르(2,560개)의 2.4배다. 프롬프트를 한꺼번에 읽는 프리필은 연산에 묶이므로 여기서 격차가 벌어지고, 토큰을 하나씩 찍는 생성은 대역폭에 묶이므로 격차가 작다.
전력 예산도 다르다. 스파크는 240W 전원 어댑터에 칩 TDP가 140W이고, 토르는 40W부터 130W까지 고른다. LLM 속도를 예고하는 숫자는 CUDA 코어 수와 메모리 대역폭이다.
같은 빌드로 잰 120B 모델: 생성 41.8, 프롬프트 938토큰
llama.cpp 같은 빌드(b6767)로 두 기기를 나란히 잰 표가 공개돼 있다. 양쪽 모두 MXFP4 GGUF를 전 레이어 GPU에 올리고, 같은 프롬프트와 같은 생성 길이로 쟀다. 120B MoE는 생성에서 DGX Spark 52.87, 젯슨 AGX 토르 41.82토큰이고, 프롬프트 처리는 1,689 대 938 tok/s다.
| 기기 | 메모리 | 모델 | 양자화 | 생성 tok/s | 프롬프트 tok/s | 필요 메모리 | 본체 가격 |
|---|---|---|---|---|---|---|---|
| 젯슨 AGX 토르 | 128GB | gpt-oss 120B | MXFP4 | 41.82 | 937.81 | 65GB | 5,499달러 |
| DGX Spark | 128GB | gpt-oss 120B | MXFP4 | 52.87 | 1,689.47 | 65GB | 6,950달러 |
| 젯슨 AGX 토르 | 128GB | gpt-oss 120B, 32K 문맥 | MXFP4 | 32.62 | 65GB | 5,499달러 | |
| DGX Spark | 128GB | gpt-oss 120B, 32K 문맥 | MXFP4 | 38.76 | 65GB | 6,950달러 | |
| 젯슨 AGX 토르 | 128GB | Qwen3.6 27B | NVFP4 | 52.33 | 5,499달러 | ||
| 젯슨 AGX 토르 | 128GB | Llama 3.3 70B | 4.7 | 5,499달러 | |||
| 젯슨 AGX 토르 | 128GB | Nemotron-3 Nano 30B-A3B | NVFP4 | 8,979 | 5,499달러 |
20B 모델에서도 비율은 비슷한 범위에 머문다. 생성은 79.74 대 57.18토큰, 프롬프트는 3,610 대 1,861토큰이다. 생성은 1.26~1.39배, 프롬프트는 1.8~1.94배가 두 모델에서 비슷한 범위로 나타났다. 프리필은 코어 수, 생성은 대역폭이 속도를 가른다는 구조가 숫자에 그대로 남아 있다.
문맥이 32K로 길어지면 격차가 1.19배로 줄어든다
같은 120B 모델을 32K 문맥에서 생성하면 38.76 대 32.62토큰이다. 기본 문맥에서 1.26배이던 격차가 1.19배로 좁혀진다. 문맥이 길어지면 KV 캐시를 읽는 비용이 커져 두 기기가 같은 벽에 부딪히는 것으로 해석된다. 짧은 질문을 계속 던지는 대화라면 스파크와의 차이가 크지 않다.
반대로 긴 문서를 한 번에 넣는 작업은 프리필에서 갈린다. 프리필 격차는 2,048토큰 입력에서 1.8~1.9배로 측정됐다. 2만 토큰짜리 로그나 코드를 한 번에 넣으면 이 격차가 대기 시간으로 더 크게 드러날 것으로 보인다. 에이전트가 문맥을 계속 다시 읽는 구조라면 이쪽이 체감 속도를 결정한다.
엔진을 바꾸면 52.3토큰, 대신 조건이 붙는다
엔비디아가 9월에 공개한 MLPerf Edge Agentic 결과는 52.33토큰이다. Qwen3.6 27B를 NVFP4로 줄이고, FP8 KV 캐시와 트리 기반 다중 토큰 예측, 대화 턴 사이 KV 재사용을 붙인 값이다. 첫 토큰까지 247ms, 토큰당 14.68ms, 함수 호출 정확도 87.94%였다.
같은 워크로드를 llama.cpp 참조 구현(Q4_K_M)으로 돌리면 2시간 37분이 걸린다. TensorRT 구현은 24분 36초에 끝냈다. 6.4배 차이는 하드웨어가 아니라 엔진에서 나온다. 다만 이 값은 최대 문맥이 약 23.5K인 에이전트 궤적 시험이고, 프롬프트 토큰의 96%를 캐시에서 꺼내 쓴 결과다. 아무 대화에서나 52토큰이 나오는 것은 아니다.
프리필은 엔진을 바꿔도 대역폭보다 코어가 먼저 걸린다. TensorRT Edge-LLM 0.8 문서에서 30B-A3B MoE를 NVFP4로 올리고 2,048토큰을 넣으면 8,979토큰이다. 엔비디아 자체 측정이고, 젯슨 토르 단일 조건이다.
70B는 4.7토큰 — 사야 하는 사람과 아닌 사람
엔비디아 공식 vLLM 표를 보면 Llama 3.1 8B가 단일 스트림 41.3토큰, Llama 3.3 70B가 4.7토큰이다. 70B를 4비트로 줄이면 43GB로 128GB 안에 들어가지만, 토큰마다 읽어야 하는 양이 대역폭을 넘어서 속도가 나오지 않는다. 들어간다는 것과 쓸 만하다는 것은 다르다.
실사용은 더 낮다. 7월에 한 개발자가 서비스가 돌고 있는 토르에서 Qwen2.5 7B를 재보니 단일 약 16토큰, 4개 동시 요청 합계 약 56토큰이었다. 카메라와 검색, 관리 프로세스가 함께 도는 상태다. 벤치마크 숫자와 현장 숫자는 이만큼 벌어진다.
120B급 MoE는 41.8토큰으로 대화가 되고, 27B는 엔진을 맞추면 50토큰을 넘는다. 70B dense는 읽히기는 하지만 기다려야 한다. 128GB라는 용량은 "무엇이든 들어간다"는 뜻이지 "무엇이든 빨라진다"는 뜻이 아니다.
값은 정가 5,499달러, DGX Spark 정가는 6,950달러다. 스파크보다 약 1,450달러 싸지만, 책상 위에서 쓰려고 사면 프리필에서 최대 45% 느리다(1,689 대 938 tok/s).
로봇이나 검사 장비 안에서 모델을 돌리는 것이 목적이면 토르다. 전력을 40W까지 낮출 수 있고, QSFP28 1포트(4×25GbE)와 JetPack 7이 기본으로 붙는다. 책상 위에서 코딩 모델을 돌리려면 DGX Spark가 낫다.
젯슨 AGX 토르는 128GB짜리 로봇용 컴퓨터다. 128GB짜리 데스크톱이 아니다. 살 때는 돌릴 모델의 크기와 함께, 프롬프트를 얼마나 길게 넣을지를 먼저 봐야 한다.
젯슨 AGX 토르 개발자 키트 Jetson AGX Thor Developer Kit
쿠팡에서 확인하기이 포스팅은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.