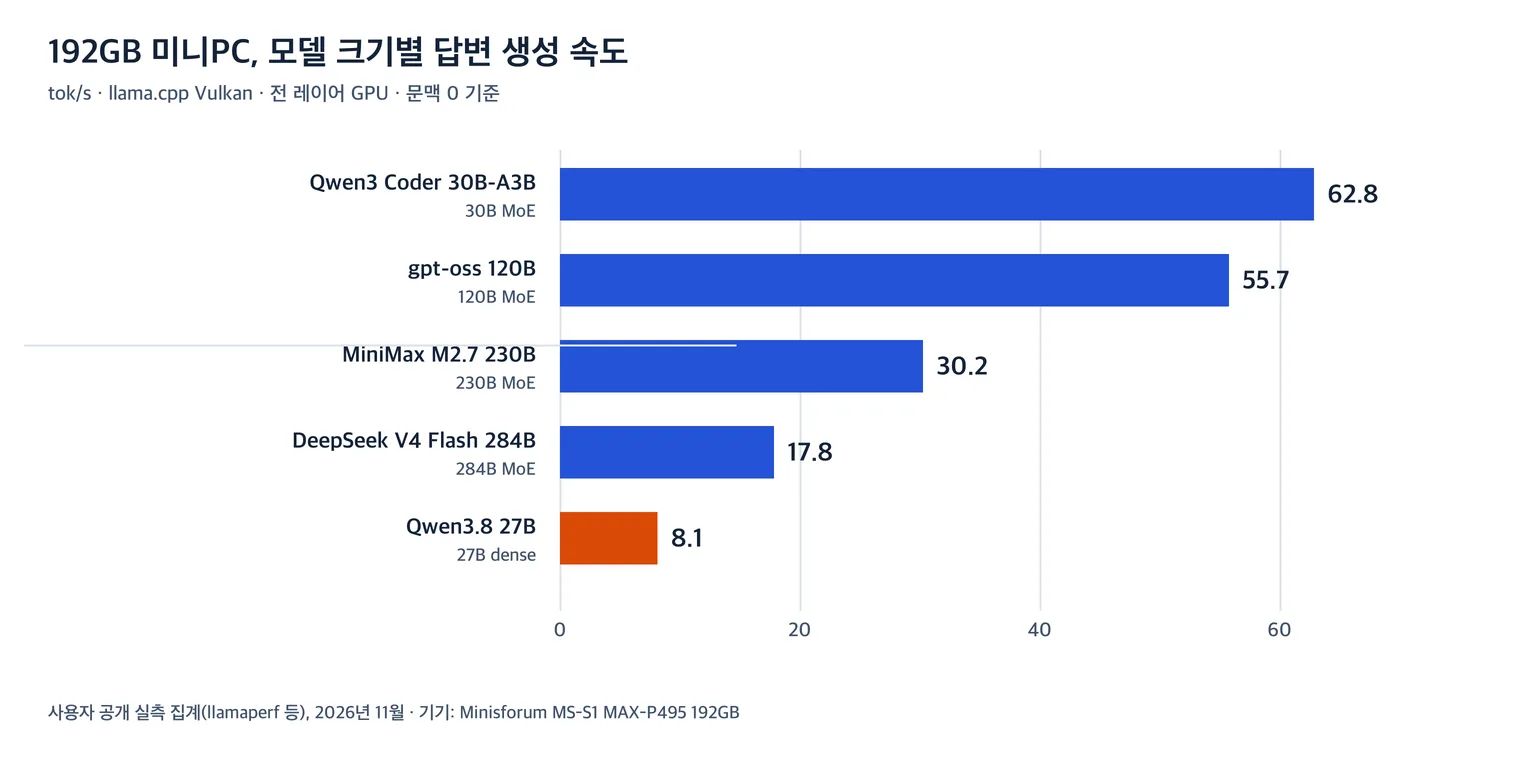
192GB 미니PC는 200B를 넘는 MoE 모델을 한 대에 올리는 기기다. MiniMax M2.7 230B가 초당 30.2토큰, DeepSeek V4 Flash 284B가 초당 17.8토큰으로 답한다. 윈도우에서 그래픽 메모리를 96GB까지만 넘길 수 있는 128GB 기기에서는 이 모델들이 들어가지 않는다.
미니스포럼 MS-S1 MAX-P495는 AMD Ryzen AI Max+ PRO 495에 192GB LPDDR5X를 붙인 2.8kg 워크스테이션이다. 192GB 가운데 160GB까지 그래픽 메모리로 넘길 수 있고, 미국 판매가가 7,399달러다.
192GB 미니PC, 128GB와 갈리는 지점
칩은 128GB짜리 Strix Halo와 거의 같다. 16코어 32스레드, Radeon 8065S 40 CU, NPU 55 TOPS. 클럭이 5.1GHz에서 5.2GHz로, 메모리가 LPDDR5X-8000에서 8533으로 올랐다. 대역폭은 256GB/s에서 273GB/s로 6.6% 늘었다.
Micro Center가 두 세대를 같은 조건에서 비교한 값도 이 차이를 보여준다. 최고 생성 속도는 51.2토큰에서 52.2토큰으로 2% 늘었고, 8,600~9,500토큰짜리 긴 프롬프트 처리는 모델에 따라 평균 1.7% 빨라졌다. 4시간 부하 시험에서는 11.66토큰이 12.06토큰이 됐고, GPU 온도는 85도에서 80도로 내려갔다. 세대 차이는 생성 2%, 4시간 연속 부하 3.4% 수준이다.
진짜 차이는 용량이다. 128GB 기기는 윈도우에서 그래픽에 96GB 정도만 넘길 수 있고, 리눅스에서도 실사용 할당이 110GB 남짓이다. 192GB 기기는 최대 160GB까지 넘길 수 있다. 284B 모델을 3~4비트로 줄이면 110~144GB 안팎이므로, 이 64GB 차이가 모델을 올릴 수 있느냐 없느냐를 가른다.
공개 측정값: 120B는 55.7, 284B는 17.8토큰
같은 기기에서 llama.cpp Vulkan으로 잰 값이 공개돼 있다. 제조사 최대 GPU 할당은 160GB이고, 이 사용자는 리눅스에서 GTT 한도를 170GB로 올린 뒤 KV 캐시를 8비트로 줄였다.
| 기기 | 메모리 | 모델 | 양자화 | 생성 tok/s | 프롬프트 tok/s | 필요 메모리 | 본체 가격 |
|---|---|---|---|---|---|---|---|
| MS-S1 MAX-P495 | 192GB | gpt-oss 120B | MXFP4 | 55.7 | 1,135 | 59GiB | 7,399달러 |
| MS-S1 MAX-P495 | 192GB | MiniMax M2.7 230B | UD-IQ4_XS | 30.2 | 309 | 101GiB | 7,399달러 |
| MS-S1 MAX-P495 | 192GB | DeepSeek V4 Flash 284B | UD-IQ3_S | 17.8 | 238 | 7,399달러 | |
| MS-S1 MAX-P495 | 192GB | Qwen3 Coder 30B-A3B | Q8_0 | 62.8 | 1,692 | 7,399달러 | |
| MS-S1 MAX-P495 | 192GB | Qwen3.8 27B | Q8_0 | 8.1 | 466 | 7,399달러 | |
| MS-S1 MAX-P495 | 192GB | DeepSeek V4 Flash 284B | Q4 | 12.35 | 144GB | 7,399달러 |
같은 284B 모델이 3비트에서 17.8토큰, 4비트에서 12.35토큰이다. 양자화를 낮추면 빨라지지만 답변 품질은 내려간다. 4비트 144GB 구성은 128GB 기기에서 확실히 어렵고, 3비트도 여유가 거의 없다.
속도가 모델 크기에 반비례하지 않는 이유는 활성 파라미터다. gpt-oss 120B는 117B 가운데 토큰마다 5.1B만 계산하고, DeepSeek V4 Flash 284B도 13B만 읽는다. MiniMax M2.7은 230B 가운데 10B를 쓴다. 전체 가중치는 메모리에 있어야 하지만, 토큰 하나에 읽는 양은 그 일부다. 그래서 120B가 284B보다 3배 빠른 정도에서 그친다.
문맥이 32k로 길어지면 숫자가 달라진다
문맥을 32k까지 채우면 gpt-oss 120B는 42.3토큰, MiniMax M2.7은 14.7토큰, DeepSeek V4 Flash는 13.2토큰으로 내려간다. 프롬프트 처리 속도는 더 크게 떨어진다. 1,135토큰이던 gpt-oss가 385토큰, 309토큰이던 MiniMax가 51토큰이다.
여기에는 설정 함정이 있다. llama.cpp 기본 배치(ubatch 512)로 MiniMax를 32k에서 재면 프롬프트 처리가 초당 13.3토큰까지 떨어지고 GPU가 응답을 멈추는 오류가 난다. ubatch를 128로 낮추면 같은 조건에서 77.5토큰이 나온다. KV 캐시도 마찬가지다. 16비트 캐시에서 32k 프롬프트 처리가 15토큰이던 것이 플래시 어텐션을 끄면 49토큰, KV 캐시를 8비트로 바꾸면 133토큰이 된다. 숫자가 이상하면 하드웨어가 아니라 설정을 먼저 본다.
dense 모델은 이 기기에서 느리다
Qwen3.8 27B를 8비트로 올리면 초당 8.1토큰, 6비트로 줄여도 9.0토큰이다. MTP를 붙이면 24토큰까지 오르지만 보조 모델을 따로 물리는 방식이다. 27B 하나를 쓰려고 7,000달러를 쓰는 건 낭비다.
dense 모델은 토큰 하나를 만들 때 가중치 전체를 읽는다. 27B 8비트면 29GB를 매 토큰 읽어야 하고, 273GB/s로는 9토큰이 상한이다. 반대로 MoE는 일부만 읽으니 같은 대역폭에서 세 배 이상이 나온다. 이 기기는 MoE를 위한 상자다.
값과 단점, 사야 하는 사람
미국 판매가는 7,399달러, 정가는 9,249달러다. 11월 중순 출하 예정이고, 같은 섀시의 128GB 구성은 국내에서도 판매된다. 192GB 구성의 국내 유통은 아직 확인되지 않는다.
소비전력은 성능 모드 120W, 무게 2.8kg이고 10GbE 두 개에 USB4 v2 두 개가 붙는다. 4시간 연속 부하에서도 12토큰을 유지하고 GPU 온도는 80도였다.
소프트웨어는 Vulkan이 정답에 가깝다. ROCm은 장문 생성이 절반 이하로 떨어졌고, 튜닝한 Vulkan이 프롬프트와 생성 모두 우세했다. 윈도우는 그래픽 메모리 할당에 별도 상한이 걸린다. 리눅스에서 GTT로 160GB를 쓰는 편이 낫다.
200B급 MoE를 한 대에서 계속 돌리는 게 목적이면 이 기기다. 100B 이하만 쓴다면 128GB 기기로 충분하고, 속도가 우선이면 RTX 5090(1,792GB/s·32GB)이나 RTX PRO 6000(1,792GB/s·96GB)처럼 대역폭이 훨씬 큰 외장 카드가 낫다. 300B dense 모델은 4비트로 줄여 약 150GB를 매 토큰 읽어야 해서, 273GB/s 기준 초당 1~2토큰 수준으로 추정된다. 실용 범위가 아니다.
192GB는 "큰 모델이 들어간다"는 뜻이고, "빨라진다"는 뜻이 아니다. 살 때는 돌릴 모델의 전체 크기와 활성 파라미터를 먼저 확인해야 한다.
미니스포럼 MS-S1 맥스 미니 AI 워크스테이션 PC 128GB LPDDR5 4TB SSD
로켓배송으로 바로 받기이 포스팅은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.