Arete-27B는 누스 리서치(Nous Research)가 알리바바 Qwen3.8-27B를 이어받아 만든 27B 오픈웨이트 모델입니다. 정치적으로 민감한 주제에서 중국 정부의 설명을 그대로 받아들이는 답변을 줄이겠다는 목표로 감독학습을 다시 돌렸고, 자사 평가에서 그 비율이 22%에서 0.9%로 떨어졌다고 밝혔습니다.
로컬에서 27B급 모델을 돌리는 사람에게 이 발표의 핵심은 성능이 아닙니다. 오픈웨이트 모델의 성향은 파인튜닝 한 번이면 바뀐다는 점, 그리고 그 파인튜닝에 쓴 데이터까지 같이 공개됐다는 점입니다. 가중치는 아파치 2.0, 학습 데이터는 별도 데이터셋으로 올라왔습니다.
반대편 숫자도 봐야 합니다. 공개된 데이터셋을 직접 훑은 독립 감사는 최종 학습 대상 29,236건 가운데 17,581건(60.1%)이 회사 자체 자동 검수에서 5점 만점에 2점을 받았다고 적었습니다. 점수 분포일 뿐 오류율은 아니지만, 모델 성능표보다 학습 데이터를 먼저 보라는 신호로 읽힙니다.
Arete-27B가 내건 숫자, 사실 점수 2.32에서 2.98
평가는 803개 질문으로 이뤄집니다. 표현의 자유, 국가 이데올로기, 국가 대 시장, 교육, 데이터 프라이버시와 감시, 민주주의, 환경 정책까지 일곱 범주입니다. 질문마다 원문 기사에서 필수 사실 2~4개를 뽑아 두고, 답변이 그 사실을 말했는지 빠뜨렸는지 반대로 말했는지를 채점합니다.
채점은 Grok 4.7에 맡겼고, 어느 모델이 쓴 답변인지는 알리지 않았습니다. 결과는 사실 점수 2.32에서 2.98(5점 만점), 정부 설명을 자기 주장으로 삼은 답변이 22%에서 0.9%입니다. 0점을 받은 답변도 803건 중 359건에서 216건으로 줄었습니다.
표현의 자유 범주에서 변화가 컸습니다. 사실 점수가 0.89에서 2.44로 오르고, 같은 범주의 편향 답변 비율은 60%에서 1%가 됐습니다.
| 모델 | 사실 점수(0~5) | 편향 답변 비율 |
|---|---|---|
| Inkling (교사 모델) | 3.96 | 0.3% |
| Mistral Large 4 | 3.65 | 0.3% |
| Gemma 4 31B | 2.58 | 0.5% |
| GLM 5.3 | 3.10 | 15% |
| DeepSeek V4.1 Flash | 2.39 | 16% |
| Qwen3.8-27B (출발 모델) | 2.32 | 22% |
| Arete-27B | 2.98 | 0.9% |
표의 값은 회사가 공개한 결과입니다. 모델마다 온도 설정이 같지 않아 같은 조건끼리 비교하려면 카드에 적힌 조건을 따라야 합니다. 온도를 0.6으로 맞춘 비교에서는 출발 모델 2.24, Arete-27B 2.88입니다.
능력 지표는 크게 흔들리지 않았다고 회사는 밝혔습니다. 자체 일반 역량 평가는 65.77%에서 65.60%로 사실상 같고, Terminal-Bench-2.1은 67%에서 70%로 올랐지만 회사는 이 상승을 자기 공으로 돌리지 않았습니다.
학습은 강화학습 없이 SFT만, 1,202스텝
방식은 단순합니다. 강화학습도, 선호 최적화도, 구조 변경도 없이 감독학습(SFT)만 썼습니다. 64k 문맥에서 시퀀스 패킹 없이 5,280만 토큰을 두 에포크, 1,202스텝 돌렸습니다. 배치 48, 텐서 병렬 4, bf16 연산에 fp32 마스터 가중치를 쓴 설정이 카드에 적혀 있습니다.
교사 모델은 누스 리서치가 고른 Inkling입니다. 일곱 범주에 걸쳐 2만 개 프롬프트를 만들고 중복을 제거한 뒤, 평가 세트와 겹치는 질문을 빼고 교사 답변을 모았습니다. 회사는 사전학습 규모에 견줘 후속 학습 비용이 크지 않다고 적었습니다.
이 대목이 27B급 모델을 쓰는 사람에게 실질적입니다. 같은 방식으로 자기 데이터를 얹으면 모델의 답변 습관을 바꿀 수 있다는 뜻이고, 실제로 공개 직후 양자화본 35개와 파생 파인튜닝 6개가 허브에 올라왔습니다.
학습 데이터 29,236건 중 60%가 자체 검수 2점
공개 데이터셋을 둘러싼 지적은 구체적입니다. 2026년 11월 8일 공개된 독립 감사 기록은 후보 쌍 34,878건 가운데 최종 학습 대상으로 표시된 29,236건을 전수 스캔했습니다. 그중 17,581건이 회사 자체 자동 검수에서 정확도 2점을 받았습니다.
감사는 이 점수를 오류율로 읽으면 안 된다고 스스로 한계를 밝혔습니다. 대신 외부 자료로 교차 확인한 10건을 따로 적었습니다. 1998년 미국 상원의 나토 가입 승인 표결을 78대 19로 적었지만 실제 기록은 80대 19였고, 마카오 국가안보법을 법률 8/2009로 적었지만 2/2009가 맞습니다.
평가의 범위도 지적 대상입니다. 이 평가는 중국 정부 설명을 받아들이는지에만 벌점을 줍니다. 미국이나 나토의 공식 설명을 받아들이는지는 대응 지표가 없어서, 결과는 특정 평가 도구에서의 개선일 뿐 일반적 중립성을 뜻하지 않습니다.
데이터 선택 자체를 본 대목도 있습니다. 질문을 미국 관점, 중국 관점, 중립으로 나눠 보면 교사 답변 채택률이 85.29%, 75.41%, 89.74%였습니다. 중국 관점이 9.9%포인트 낮지만 감사는 질문 내용과 난이도, 교사 성능 차이일 수 있어, 데이터만으로 의도된 편향을 단정할 수 없다고 적었습니다.
해커뉴스 댓글은 평가 설계부터 문제를 제기합니다. 한 이용자는 "내 단위 테스트에 왜 서구적 가치가 필요한가"라고 썼고, 다른 이용자는 "Grok을 심판으로 고른 게 가장 의외"라며 판정 모델 선택을 의심했습니다. 답변 전후를 나란히 공개해 달라는 요구도 나왔습니다.
27B를 로컬에서 돌리려면 메모리 얼마
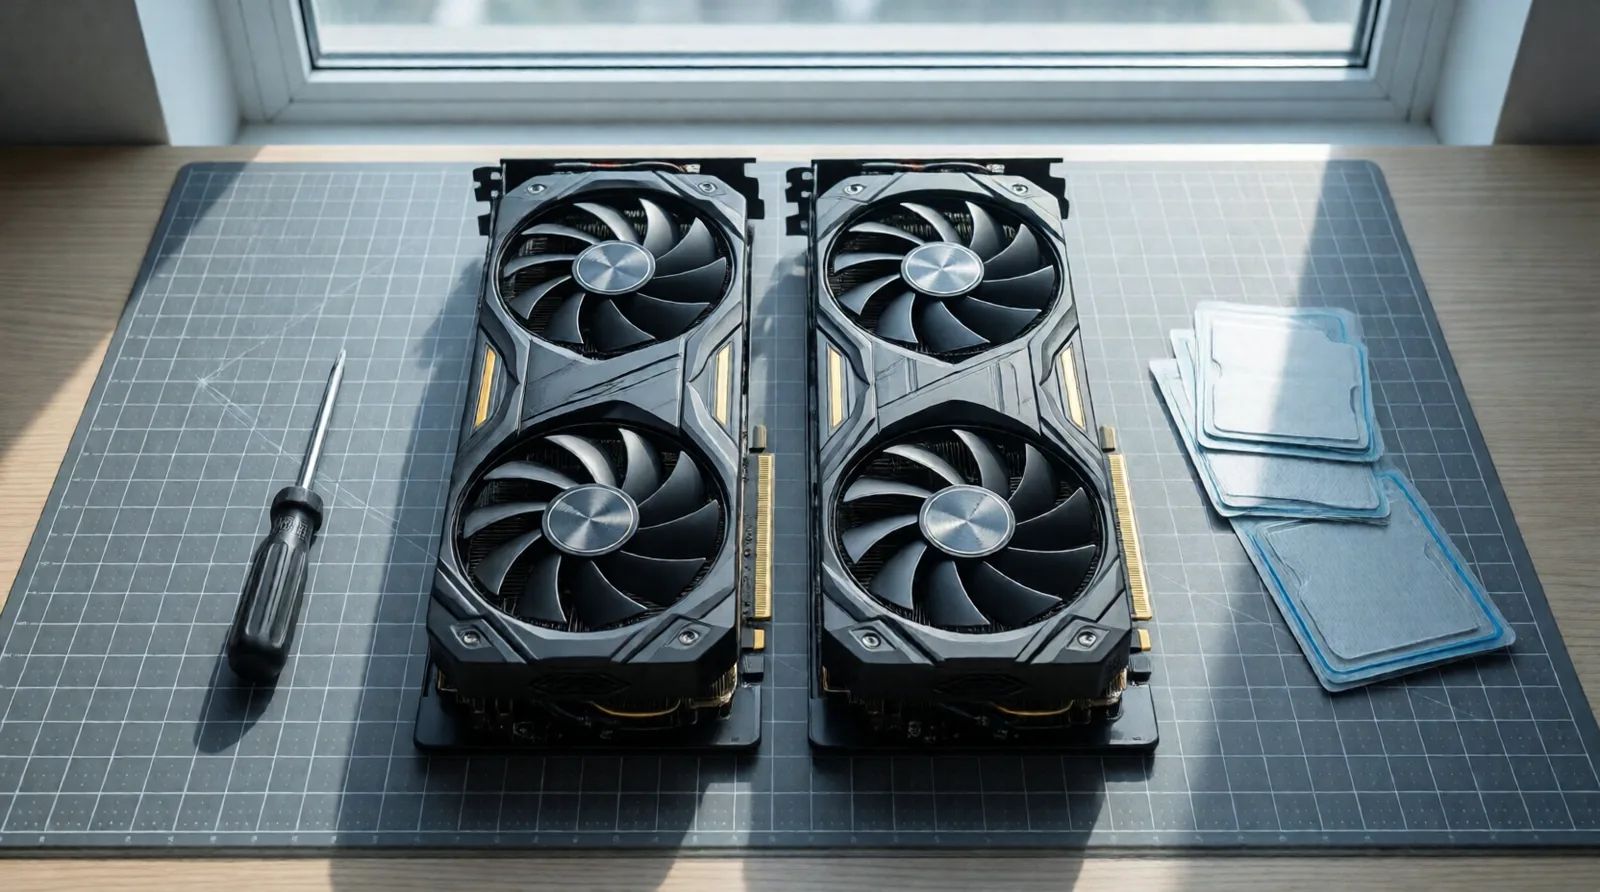
27B 파라미터에 bf16(2바이트)을 곱하면 가중치만 54GB입니다. 32GB 그래픽카드 두 장이나 96GB급 카드가 필요합니다. 8비트로 줄이면 약 27GB, 4비트로 줄이면 15GB 선으로 계산됩니다. 4비트는 24GB 카드 한 장에도 들어가고, 8비트는 32GB 한 장에서 문맥 여유가 거의 없습니다.
문맥을 64k까지 늘리면 키·값 캐시가 위 숫자에 더해집니다. 학습 문맥이 64k라는 사실이 추론도 같은 길이로 돌아간다는 뜻은 아니므로, 실제로 쓸 문맥 길이에서 메모리를 재는 편이 정확합니다.
구조도 한 가지 확인할 부분이 있습니다. 이 모델은 비전 인코더를 고정한 채 언어 쪽만 학습했고 멀티토큰 예측 헤드는 학습 중 껐습니다. 이미지 입력을 쓰는 워크로드라면 원본 베이스 모델의 동작을 따로 확인해야 합니다.
지금 받아볼까, 기다릴까
라이선스가 아파치 2.0이고 학습 데이터까지 공개됐으니, 직접 검사할 사람에게는 지금 받을 이유가 충분합니다. 다만 한국어 품질은 이 발표의 평가 범위가 아닙니다. 따로 재야 하고, 그 판단을 대신해 줄 숫자는 이 발표에 없습니다.
업무에 넣으려면 확인 순서를 바꾸는 편이 낫습니다. 모델 점수표보다 최종 학습셋의 검수 점수 분포, 평가가 실제로 재는 대상, 같은 질문의 전후 답변을 먼저 보십시오. 세 가지가 확인되지 않으면 모델이 좋아진 것이 아니라 좋아졌다고 주장하는 지표가 하나 생긴 셈입니다.
한 줄 정리: Arete-27B는 5,280만 토큰 SFT로 답변 성향이 바뀌었다. 바뀐 방향이 의도한 쪽인지 확인하는 일은 가중치를 받는 사람 몫으로 남았다.
모델 소개 원문 · 가중치와 모델 카드 · 데이터셋 독립 감사 기록
GIGABYTE GIGABYTE AORUS 지포스 RTX 5090 STEALTH ICE D7 32GB 제이씨현
로켓배송으로 바로 받기이 포스팅은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.