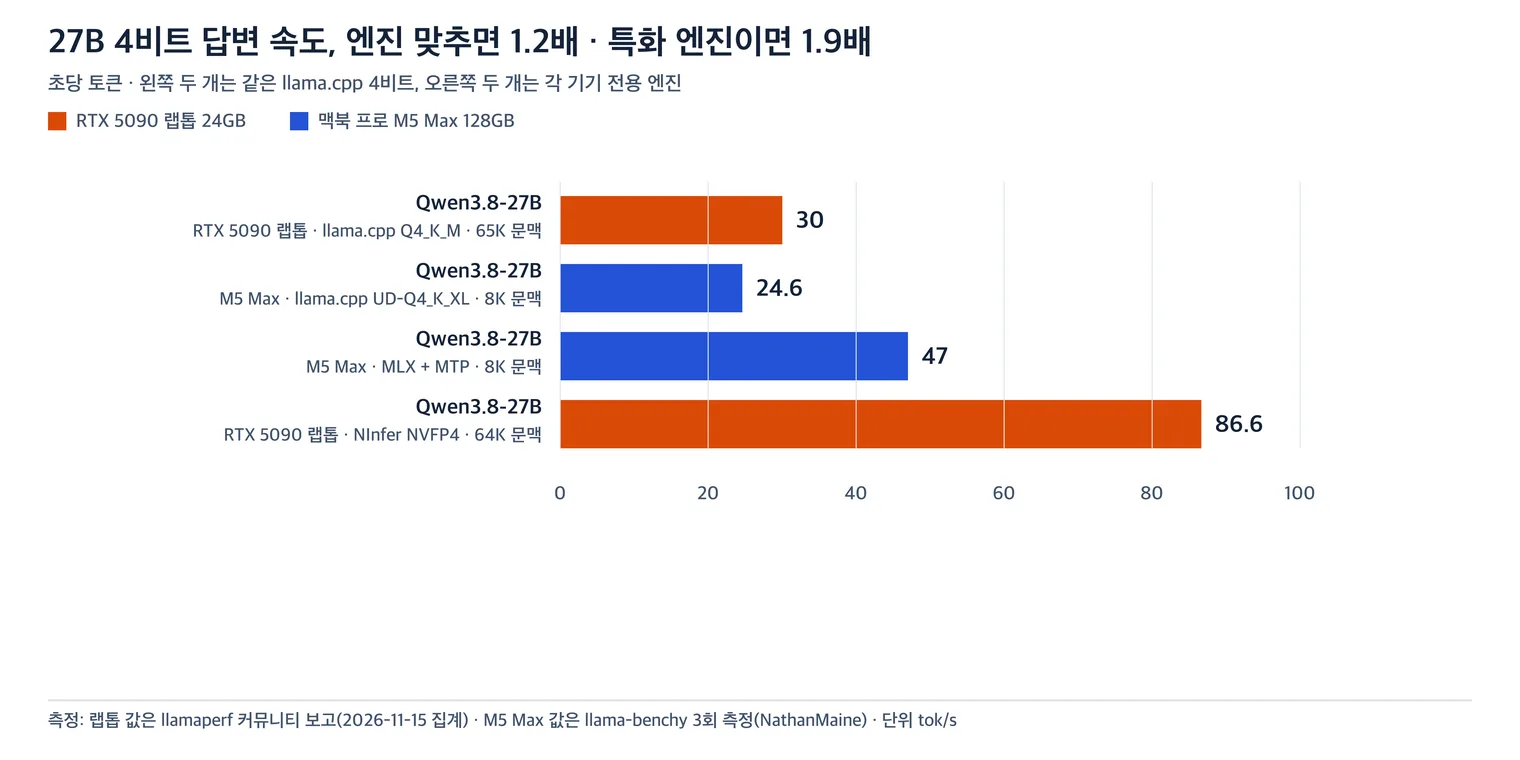
노트북 로컬 LLM에서 Qwen3.8-27B를 4비트로 돌리면, 같은 llama.cpp 조건에서는 RTX 5090 노트북이 초당 30.0토큰, 맥북 프로 M5 Max 128GB가 24.6토큰이다. 1.2배 차이다. 그런데 각 기기에 맞는 엔진을 켜면 M5 Max는 MLX에 MTP를 붙여 47.0토큰, RTX 5090 노트북은 NInfer로 86.6토큰이 되어 1.8배로 벌어진다. 이미지 한 장은 두 모델 모두에서 RTX 5090 노트북이 1.6배 빨랐다.
숫자는 공개된 측정 기록에서 가져왔고, 엔진과 양자화, 문맥 길이를 표의 조건 열에 적었다.
llama.cpp로 맞추면 1.2배 차이
프롬프트 처리와 답변 생성은 다른 단계다. 프롬프트 처리는 입력 전체를 한 번에 읽는 행렬 연산이라 연산 유닛이 속도를 정하고, 답변 생성은 토큰 하나마다 가중치를 다시 읽는 작업이라 메모리 대역폭이 정한다. 두 값을 한 줄에 섞으면 기기 성격이 사라지므로 표에서도 열을 나눴다.
27B 4비트는 두 기기 모두 메모리에 들어간다. M5 Max에서 MLX 4비트 파일이 16.1GB이고, 24GB 노트북에서 65K 문맥에 8비트 KV 캐시를 두면 21GB를 쓴다. 양쪽 다 여유가 크지 않으므로 문맥을 늘리면 다른 프로그램을 내려야 한다.
| 작업 | 기기 | 엔진·설정 | 프롬프트 처리 | 답변 생성 | 문맥 |
|---|---|---|---|---|---|
| 27B 4비트 | RTX 5090 노트북 24GB | llama.cpp Q4_K_M, 8비트 KV | - | 30.0 tok/s | 65,536 |
| 27B 4비트 | RTX 5090 노트북 24GB | Q4_K_XL | - | 37.0 tok/s | 100,000 |
| 27B 4비트 | 맥북 프로 M5 Max 128GB | llama.cpp UD-Q4_K_XL, Metal | - | 24.6 tok/s | 8,192 |
| 27B 4비트 | 맥북 프로 M5 Max 128GB | MLX + MTP | 853.8 tok/s | 47.0 tok/s | 깊이 0 |
| 27B 4비트 | RTX 5090 노트북 24GB | NInfer NVFP4 | - | 86.6 tok/s | 65,536 |
같은 llama.cpp로 맞추면 노트북이 앞선다. Q4_K_M에 65K 문맥을 둔 보고가 30.0토큰, M5 Max에서 UD-Q4_K_XL로 8K 문맥을 잰 값이 24.6토큰이다. 대역폭이 896GB/s인 노트북이 614GB/s(제조사 표기)인 맥북보다 1.46배 높은데 답변 속도 차이는 1.22배다. 1.46배가 그대로 나오지 않은 원인은 전력 한도와 커널 성숙도가 변수로 남는다.
양자화 이름도 조건이다. M5 Max에서 MLX 4비트 파일은 16.1GB, llama.cpp로 쓴 UD-Q4_K_XL은 17GB다. 동적 양자화는 레이어마다 정밀도를 달리해 같은 4비트라도 읽는 양이 달라진다. 이 차이를 지우려면 같은 파일을 양쪽에 올려야 하는데, 그런 비교 기록은 아직 없다.
llama.cpp로 잰 노트북 27B 4비트 값은 30.0과 37.0 둘이고 중앙값이 33.5토큰이다. 표본이 적으니 한 점이 아니라 30.0과 37.0 사이의 폭으로 읽는 편이 안전하다.
프롬프트 처리 속도는 한쪽만 값이 있다. M5 Max가 프롬프트를 읽는 속도는 MLX 경로의 짧은 문맥에서 853.8 tok/s이고, 깊이 8,192에서 809.8 tok/s로 5% 줄어든다. 27B 기준 노트북의 프롬프트 처리 수치는 보고에 없어 표에서 비웠다. 같은 카드에서 다른 모델로 잰 2,993토큰은 125B 모델 값이라 이 줄에 끼워 넣을 수 없다.
특화 엔진을 켜면 1.8배로 벌어진다
두 기기 모두 자기에게 맞는 엔진이 따로 있다. M5 Max는 MLX에 MTP 보조 디코더를 붙여 47.0토큰을 냈고, MLX로 세 가지 프롬프트를 돌린 별도 측정의 평균은 49.2토큰이다. MTP의 효과는 8비트에서 더 분명하다. 세 프롬프트 평균이 MTP를 붙이면 34.1토큰, 빼면 15.5토큰이다. 엔진 선택이 하드웨어 차이보다 큰 폭을 만든다는 뜻이다. RTX 5090 노트북은 NInfer에서 NVFP4 64K 문맥 86.6토큰, 8비트 132K 문맥 82.5토큰을 보고했다.
비트 수를 올리면 속도가 떨어진다. M5 Max에서 MTP를 켠 채 같은 측정 도구로 비트 수만 8비트로 올리면 47.0토큰이 28.7토큰으로 줄고, 메모리는 상주 기준 15.5GB에서 28.1GB로 약 1.8배 늘어난다(파일은 16.1GB와 28GB). 4비트가 8비트보다 1.6배 빠르고 메모리는 파일 16.1GB·상주 15.5GB 대 28.1GB로 약 1.8배 차이이므로, 24GB 노트북에서도 4비트를 쓰는 이유가 같다. 노트북에서 27B 4비트가 65K 문맥에 21GB를 쓰는 것도 이 계산 위에 서 있다.
MTP를 쓰려면 조건이 붙는다. GGUF 파일에는 MTP 가중치가 들어 있는데 llama.cpp가 이를 버리고 무시한다. 그래서 맥에서도 MTP를 쓰려면 MLX 경로로 옮겨야 하고, llama.cpp끼리 비교하면 양쪽 모두 MTP 없이 재는 셈이다. 추측 디코딩은 검증 단계에서 모델이 초안 토큰을 다시 확인하므로 출력이 달라지지 않고 속도만 달라진다.
같은 27B인데 기기와 엔진 조합을 바꾸면 24.6토큰에서 86.6토큰까지 벌어진다. 기기 순위를 따지기 전에 내가 쓸 엔진이 어느 쪽에 최적화되어 있는지를 먼저 보는 편이 낫다. 노트북 보고는 65K~132K 문맥이 기준이고, 맥 쪽은 8K 문맥에서 잰 값이 기준으로 쓰인다.
이 차이를 분당으로 옮기면 27B가 초당 30토큰일 때 1분에 1,800토큰, 86.6토큰일 때 5,196토큰이다. 1,000토큰짜리 답변 하나가 33.3초와 11.5초로 갈린다. 하루에 긴 답변을 수십 번 받는 작업이라면 이 차이가 대기 시간으로 쌓인다.
이미지는 두 모델에서 같은 방향, 1.6배
이미지 생성은 결이 다르다. 확산 모델은 스텝마다 트랜스포머 전체를 한 번씩 통과하므로 연산량이 그대로 시간이 된다. 경량 LoRA로 스텝을 줄이면 두 기기 모두 시간이 크게 줄지만, 줄어드는 폭은 기기마다 다르다.
| 모델·설정 | RTX 5090 노트북 24GB | 맥북 프로 M5 Max 128GB | 배수 |
|---|---|---|---|
| Qwen-Image 2512, 4스텝, 1328² | 12.2초 | 19.9초 | 1.6배 |
| Z-Image Turbo, 1024² | 13.8초 (8스텝) | 22.2초 (9스텝) | 1.6배 |
| FLUX.2 Klein 9B, 4스텝, 1024² | - | 9.4초 | - |
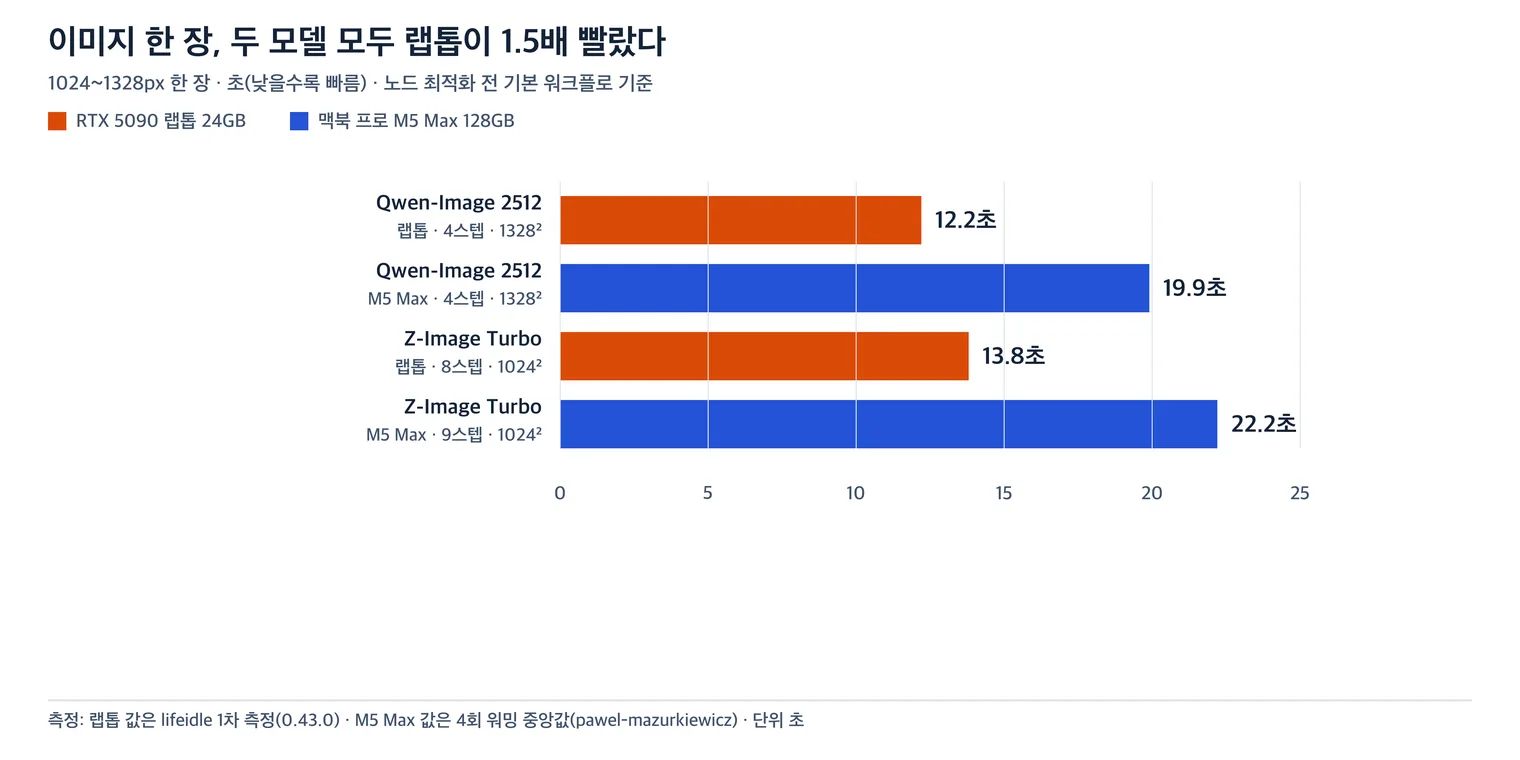
Qwen-Image 2512에 4스텝 경량 LoRA를 붙인 1328²에서 노트북이 12.2초, M5 Max가 19.9초다. Z-Image Turbo 1024²는 13.8초와 22.2초다. 두 모델 모두 1.6배로 같은 방향이다. M5 Max에 FP8 가속 노드를 붙이면 Qwen-Image는 18.4초, Z-Image는 12.6초로 좁혀지고, 노트북도 커널 최적화 뒤 Z-Image를 4.0초까지 낮춘 기록이 있다.
100장을 뽑는다고 가정하면 20.3분과 33.2분이다. 한 시간 안쪽이면 둘 다 끝나는 양이지만, 프롬프트를 고쳐가며 수백 장을 반복하면 차이가 시간 단위로 벌어진다.
맥에서 시간이 어디로 가는지도 기록돼 있다. FLUX.2 Klein 9B에서 첫 텍스트 인코드가 9.71초 걸렸고, 1328² Qwen-Image의 VAE 디코드가 2.07초였다. 같은 단계가 가속 노드에서 0.97초와 0.36초로 줄었다. 샘플링보다 앞단과 뒷단이 병목이었다는 뜻이고, 스텝만 줄여서는 줄지 않는 구간이 있다는 뜻이기도 하다.
Z-Image 줄은 스텝이 8과 9로 다르다. 스텝 한 번 차이를 감안해도 격차가 뒤집히지 않으며, 같은 4스텝 조건에서 잰 Qwen-Image 줄이 방향을 확인해 준다. FLUX.2 Klein 9B는 M5 Max 값만 있어 노트북과 견주지 않았다. 노트북에서는 이 모델을 편집 2패스로 1024²에 18.9초에 끝낸 기록이 있는데, 편집과 생성은 같은 작업이 아니라 표에서 뺐다.
노트북 로컬 LLM에서 24GB와 128GB가 가르는 것
속도보다 먼저 확인할 숫자는 모델 파일 크기다. 27B 4비트가 16~17GB이므로 24GB 노트북에서는 이 급이 사실상 상한이다. 65K 문맥에 8비트 KV 캐시를 두면 21GB를 쓰니 문맥을 더 늘릴 여유가 적다. M5 Max 128GB는 같은 모델을 올려두고도 262K 문맥까지 열어둘 수 있다. 대신 문맥이 길어질수록 느려지는 성질은 같아서, 깊이 0에서 47.0토큰이던 디코드가 깊이 8,192에서 36.1토큰으로 23% 떨어졌다.
문맥을 100K까지 열어둔 노트북 보고는 37.0토큰이다. 다만 이 값은 시스템 RAM 64GB를 전제로 하고, 24GB 카드에는 모델 16~17GB와 KV 캐시가 함께 올라가 여유가 남지 않는다. 문맥 길이를 늘리는 선택은 곧 다른 프로그램을 포기하는 선택이 된다.
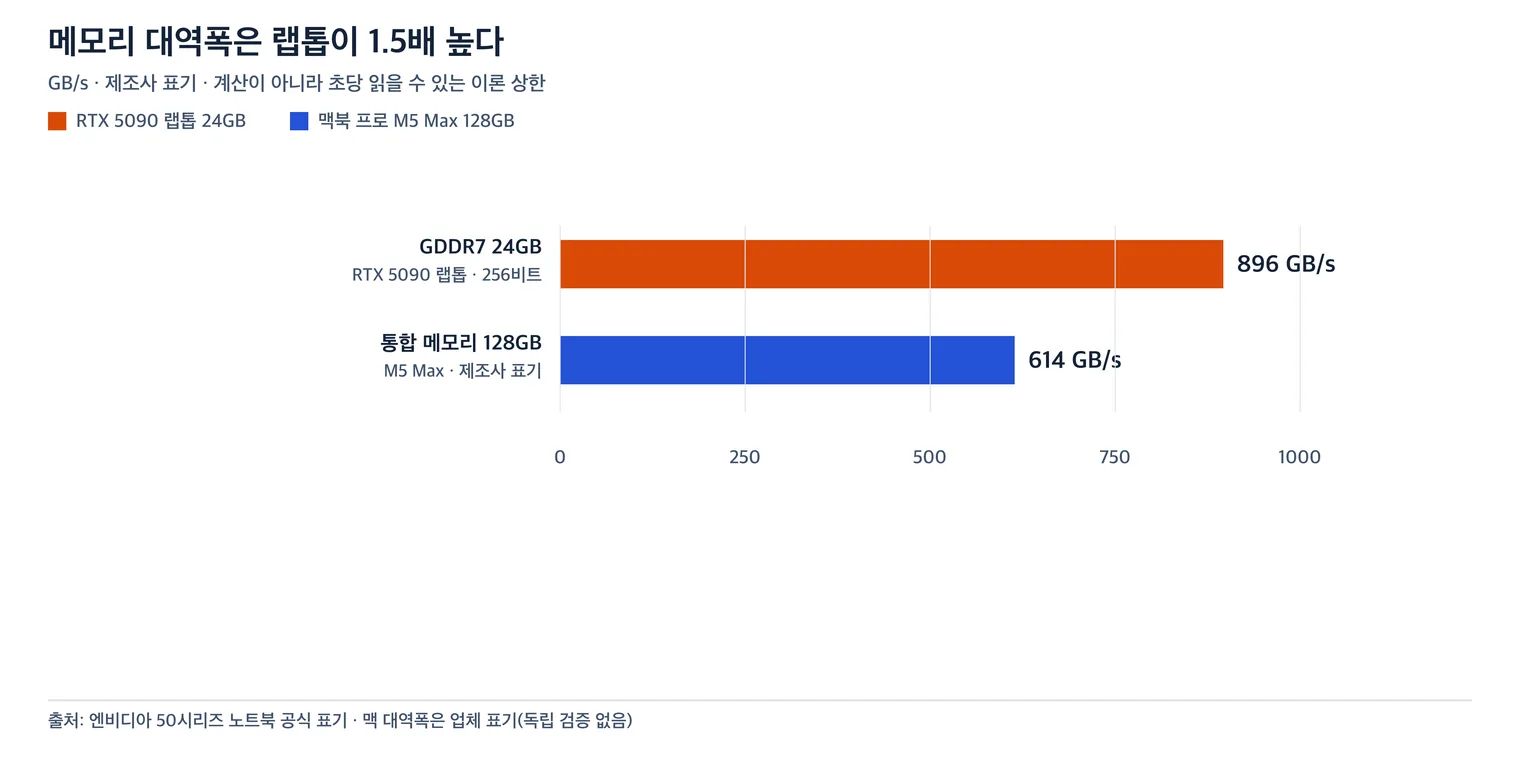
대역폭은 이론 상한일 뿐이다. 896GB/s와 614GB/s는 초당 읽을 수 있는 최대치이고, 실제 토큰 속도는 커널과 배치 크기, KV 캐시 형식이 함께 정한다. 대역폭이 1.46배 높다고 답변이 그만큼 빨라지지 않는 이유가 여기에 있다. 반대로 이미지처럼 연산을 반복하는 작업은 연산 유닛 수와 전력이 그대로 시간에 반영된다.
전력은 노트북 GPU가 150W다. 여기에 CPU와 화면이 더해지므로 배터리로는 오래 버티지 못한다. 같은 24GB라도 냉각 설계와 전력 한도가 달라, 얇은 기종은 표의 속도를 그대로 내지 못할 수 있다.
정리 — 노트북 한 대로 어디까지
순서는 이렇게 정리된다. 첫째, 같은 조건에서 답변 속도만 보면 RTX 5090 노트북이 1.2배 앞선다. 둘째, 엔진을 각자 최적화하면 격차가 1.8배로 벌어진다. 셋째, 이미지는 두 모델 모두 1.6배다. 넷째, 128GB 통합 메모리가 필요한 순간, 즉 27B보다 큰 모델을 통째로 올려두려는 순간에만 맥북 쪽 이유가 생긴다. 1,000토큰 답변은 노트북이 llama.cpp 33.3초에서 NInfer 11.5초로, 맥이 llama.cpp 40.7초에서 MLX 21.3초로 줄어든다.
27B 이하를 빠르게 돌리는 것이 목적이면 RTX 5090 노트북, 128GB에 큰 모델을 올려두고 오래 쓰는 것이 목적이면 M5 Max다. 두 작업을 한 대에서 번갈아 한다면 모델 하나만 상주시키고 나머지는 내렸다 올리는 구성이 현실적이다. 24GB에서는 이미지와 LLM을 동시에 올려두기 어렵고, 128GB에서는 두 모델을 함께 띄워두고 번갈아 쓸 수 있다.
영상 생성은 이번 비교에서 뺐다. 맥 128GB에서 Wan 2.2 A14B 4비트로 512×320 81프레임을 10분 25초에 끝낸 보고가 한 건, 노트북에서 Wan 2.2 5B로 704×384 49프레임을 34.6초에 끝낸 기록이 한 건 있다. 모델과 해상도, 프레임 수가 모두 달라 두 값을 나눠 배수로 만들 수 없다. 영상 축은 같은 조건의 측정이 2건 이상 모이면 따로 다룬다.
기가바이트 2025 어로스 마스터 16 코어Ultra9 지포스 RTX 5090
로켓배송으로 바로 받기HP 2025 오멘 MAX 16 코어Ultra9 지포스 RTX 5090
로켓배송으로 바로 받기이 포스팅은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.


