같은 Qwen-Image 2.1을 1024×1024·20스텝으로 돌리면 RTX 5090은 8.4초, MacBook Pro M5 Max는 79초가 걸립니다. 9.4배 차이입니다. 맥에서 MLX 런타임으로 바꾸면 38초까지 줄어 4.5배가 됩니다. 하루에 수백 장을 뽑아야 한다면 답은 그래픽카드이고, 한 번에 몇십 장이면 맥으로도 충분합니다.
이미지 생성 속도 비교는 조건 맞추기가 특히 어렵습니다. 해상도·스텝·양자화·엔진이 조금만 달라도 배수가 두 배씩 흔들립니다. 이번에는 Qwen-Image 2.1과 Z-Image Turbo 두 모델로 좁히고, 양쪽 다 1024×1024에 같은 스텝을 쓴 공개 실측만 모았습니다. 맥은 8비트 GGUF와 MLX, RTX 5090은 BF16 ComfyUI입니다. 엔진과 양자화가 완전히 같지는 않으니 배수는 하드웨어만의 차이가 아니라 지금 실제로 쓰는 조합의 차이로 읽어야 합니다.
| 작업 | 기기 | 모델·설정 | 해상도·스텝 | 장당 시간 | 메모리 |
|---|---|---|---|---|---|
| 이미지 | RTX 5090 32GB | Qwen-Image 2.1 BF16, ComfyUI, 575W | 1024²·20 | 8.39초 | VRAM 19.7GB |
| 이미지 | MacBook Pro M5 Max 36GB | Qwen-Image 2.1 Q8 GGUF, ComfyUI | 1024²·20 | 79초 | 통합 14GB |
| 이미지 | Mac Studio M5 Max 36GB | Qwen-Image 2.1, MLX 런타임 | 1024²·20 | 38초 | — |
| 이미지 | Mac Studio M3 Ultra 256GB | Qwen-Image 2.1, MLX 런타임 | 1024²·20 | 83초 | — |
| 이미지 | Mac mini M4 Pro 48GB | Qwen-Image 2.1, MLX 런타임 | 1024²·20 | 264초 | — |
| 이미지 | Mac mini M2 Pro 32GB | Qwen-Image 2.1, MLX 런타임 | 1024²·20 | 451초 | — |
| 이미지 | RTX 5090 32GB | Z-Image Turbo BF16, diffusers | 1024²·8 | 3.18초 | VRAM 21.7GB |
| 이미지 | MacBook Pro M5 32GB | Z-Image Turbo BF16, ComfyUI | 1024²·8 | 58.3초 | 통합 19GB |
맥의 20스텝 값은 같은 테스트의 40스텝 기록에서 스텝당 시간을 뽑아 계산한 것입니다. MacBook Pro M5 Max가 40스텝 156초, 20스텝 79초로 스텝당 3.86~3.95초입니다. 스텝을 절반으로 줄이면 시간도 거의 절반이 됩니다. RTX 5090 값은 10장을 연속 생성한 평균입니다.
같은 20스텝에서 9.4배, 차이는 연산량
Qwen-Image 2.1은 7B급 확산 트랜스포머에 Qwen3-VL 8B 텍스트 인코더를 붙인 모델입니다. 스텝 하나가 트랜스포머 전체를 한 번 통과하는 구조라, 스텝 수와 시간이 정비례합니다. RTX 5090은 20스텝을 8.39초에 끝내고 그동안 평균 522.8W를 씁니다. 1,000장이면 2.3시간, 전력은 약 1.22kWh입니다.
같은 1,000장을 MacBook Pro M5 Max로 뽑으면 21.9시간이 걸립니다. 밤새 돌려도 1,100장 수준이라는 뜻입니다. 배치 작업에서는 이 차이가 취향 문제가 아니라 처리 가능한 물량 문제가 됩니다. 다만 전력을 400W로 제한해도 RTX 5090은 10.01초로, 575W 대비 19% 느려지는 데 그칩니다. 소비전력은 522.8W에서 378.5W로 28% 줄어듭니다.
런타임을 바꾸면 79초가 38초가 된다
여기서 중요한 갈림길이 하나 있습니다. 같은 M5 Max 계열인데 MLX 런타임은 38초, ComfyUI Q8은 79초입니다. 칩이 같아도 엔진이 다르면 두 배 차이가 납니다.
MLX는 애플 GPU에 맞춰 커널을 짜고 가중치를 다루는 경로도 짧습니다. ComfyUI의 MPS 경로는 PyTorch 범용 커널을 쓰고, 8비트 가중치를 매 스텝 풀어내는 비용이 붙습니다. 맥에서 이미지 생성 속도를 볼 때 기기 이름만 보고 판단하면 안 되는 이유입니다. 같은 맥에서도 어떤 앱을 쓰느냐로 체감 속도가 갈립니다.
맥 안에서도 순위가 뒤집힌다
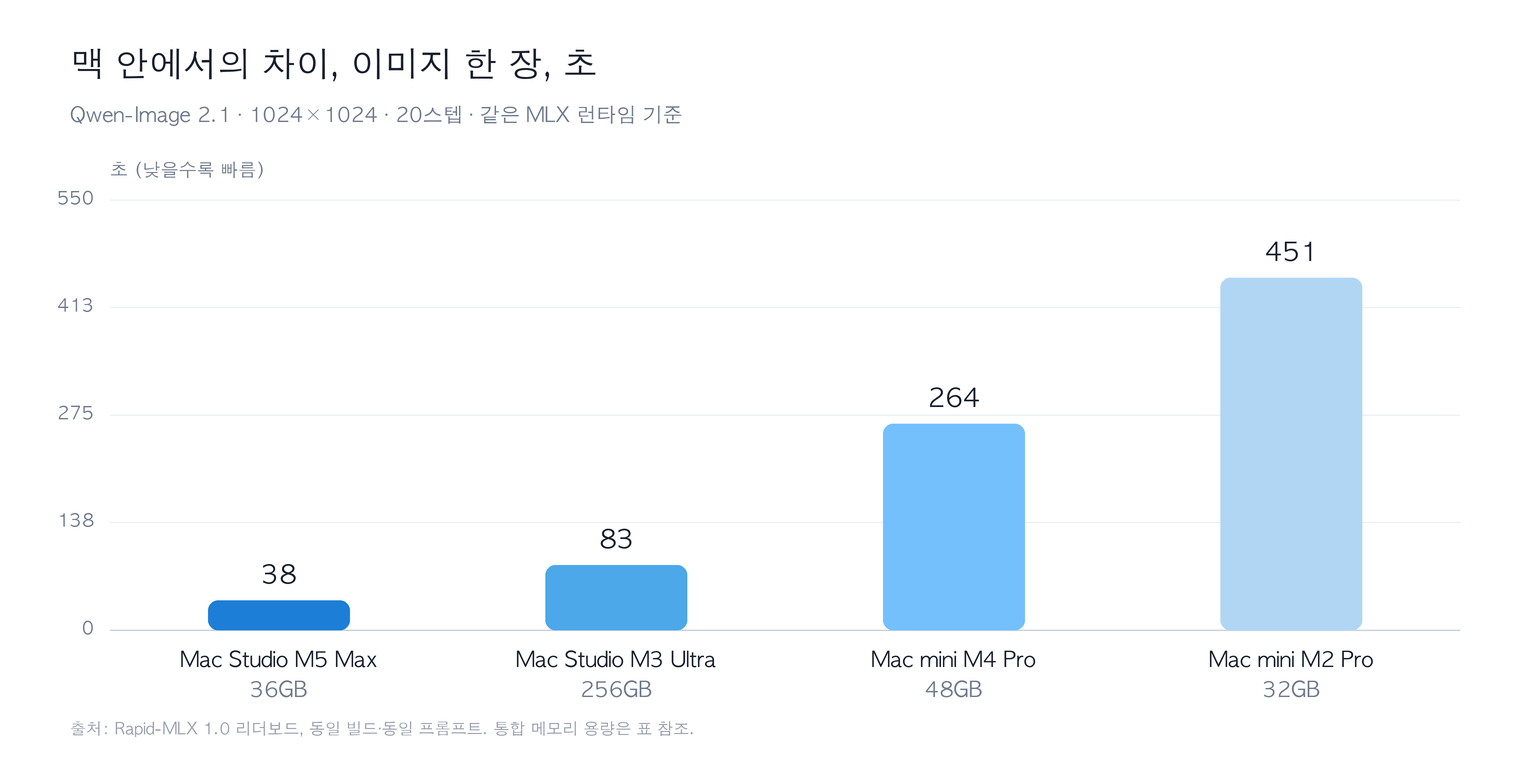
같은 MLX 런타임·같은 20스텝으로 맞추면 Mac Studio M5 Max 38초, Mac Studio M3 Ultra 83초, Mac mini M4 Pro 264초, Mac mini M2 Pro 451초입니다. M5 Max가 M3 Ultra보다 2.2배 빠릅니다. 통합 메모리는 M3 Ultra가 256GB로 7배 많지만, 이미지 한 장은 더 느립니다.
이미지 생성은 메모리 용량보다 세대와 GPU 코어에 먼저 반응합니다. 모델이 메모리에 들어가기만 하면 나머지는 연산 속도 싸움이기 때문입니다. 애플도 M5 GPU의 뉴럴 액셀러레이터를 언급하며 FLUX-dev 4비트 1024px 생성이 M4보다 3.8배 빨라졌다고 밝혔습니다. 큰 모델을 얹는 것이 목적이 아니라면, 맥은 최신 세대가 유리합니다.
모델을 가볍게 바꾸는 쪽이 더 큰 경우도 있다
Z-Image Turbo는 6B 트랜스포머로 8스텝만 돌리는 증류 모델입니다. RTX 5090에서 1024×1024 한 장이 3.18초, 분당 19장입니다. 같은 카드에서 Qwen-Image 2.1 20스텝이 8.39초였으니 모델만 바꿔도 2.6배가 납니다. 기기를 바꾸는 것보다 모델을 바꾸는 쪽이 빠를 때가 있다는 뜻입니다.
맥에서는 반대 함정이 있습니다. Z-Image Turbo를 4비트로 줄이면 58.3초에서 81.7초로 오히려 40% 느려집니다. Qwen-Image 2.1도 40스텝 기준 8비트 156초, 4비트 218초입니다. 애플 GPU는 4비트 가중치를 매 스텝 풀어내는 비용이 커서, 비트를 줄이면 메모리는 아끼지만 시간은 잃습니다. 1536px 이상으로 올리면 이 비용이 묻혀 4비트가 조금 빨라지지만, 1024px대에서는 8비트가 정답입니다.
| 맥에서 바꾼 설정 | 1024² 기준 장당 시간 | 메모리 |
|---|---|---|
| Qwen-Image 2.1 Q8, 20스텝 | 79초 | 14GB |
| Qwen-Image 2.1 Q4, 20스텝 | 114초 | 11GB |
| Qwen-Image 2.1 Q8, 40스텝 | 156초 | 14GB |
| Z-Image Turbo BF16, 8스텝 | 58.3초 | 19GB |
| Z-Image Turbo Q4_K_M, 8스텝 | 81.7초 | 12GB |

그래서 어느 쪽을 골라야 하나
하루에 수백 장을 뽑거나 프롬프트를 고쳐가며 반복한다면 RTX 5090입니다. 8.4초와 79초는 같은 작업을 하루에 몇 번 돌릴 수 있느냐를 바꿉니다. 32GB VRAM에 Qwen-Image 2.1 8비트(16GB)와 Z-Image Turbo가 함께 들어갑니다.
한 번에 몇십 장, 이동하면서 쓰거나 소음·전력이 중요하다면 맥입니다. 이때는 MLX를 쓰는 앱을 고르는 것이 조건입니다. 같은 기기에서 38초와 79초가 갈리기 때문입니다. 다만 2048×2048로 올리면 맥은 18분까지 늘어납니다. 큰 해상도를 자주 뽑는다면 맥은 답이 아닙니다.
(MANLI) MANLI 지포스 RTX 5090 Gallardo OC D7 32GB White 인텍앤컴퍼니
로켓배송으로 바로 받기이 포스팅은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.
Apple 맥북 프로 16 M5칩
로켓배송으로 바로 받기이 포스팅은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.
정리하면, 물량은 RTX 5090이고 이동성은 맥입니다. 맥을 고른다면 칩 세대와 함께 어떤 런타임으로 돌리는지를 먼저 확인하시면 됩니다.
이 포스팅은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.