멀티 에이전트 1,000개가 사람의 지휘 없이 페르마의 마지막 정리 형식화를 28.7시간에 끝냈다. 60개 정리 가운데 54개를 증명하고 최종 정리를 통과시킨 기록이다. 앤트로픽이 11월 9일 공개한 실험에서 리드 1개와 헬퍼 999개는 전용 플랫폼도, 연구자의 방향 제시도 없이 Git 저장소와 공유 데이터베이스만으로 일을 나눴다. 9월에 수십 개 에이전트가 11일 걸려 만든 결과와 비교해 출력 토큰은 3분의 1, 증명 길이는 7분의 1이었다. 에이전트를 여러 개 굴리려는 쪽에 이 실험이 남긴 것은 모델 성능표가 아니라 조율 도구와 안전 경계다.

무엇이 달라졌나, 플랫폼과 연구자를 뺐다
9월 실험은 증명 플랫폼 Prove2Me 위에서, 연구자가 방향을 잡고 수십 개 에이전트가 움직이는 구성이었다. 11일이 걸렸고 출력 토큰은 약 60억 개, Lean 코드는 1,300만 줄이었다. 이번에는 정리 60개와 고전적 경로를 한 문장으로 요약한 스케치, 정의, 이전 작업에서 증명한 보조정리 47개만 줬다. 증명 방법도 팀 구성도 지정하지 않았다.
아래 표의 두 실험은 같은 정리를 다룬다. 조건이 다른 만큼 시간과 토큰을 그대로 나눠 배수로 읽지 말고, 무엇이 빠졌는지를 보는 편이 낫다.
| 항목 | 2026년 9월 실험 | 2026년 11월 실험 |
|---|---|---|
| 에이전트 구성 | 수십 개, 연구자 지휘 | 리드 1 + 헬퍼 999 |
| 조율 도구 | 전용 플랫폼 Prove2Me | Git 저장소 + Postgres 표 5개 |
| 소요 | 11일 | 28.7시간 |
| 출력 토큰 | 약 60억 개 | 9월의 3분의 1 |
| Lean 증명 길이 | 1,300만 줄 | 9월의 7분의 1 |
표 1. 두 실험 비교. 출처는 앤트로픽 개발 블로그(2026년 11월 9일)이며, 두 실험 모두 페르마의 마지막 정리를 Lean으로 형식화한 작업이다.
멀티 에이전트 1,000개를 묶은 것은 Git 브랜치와 표 다섯 개
에이전트마다 네트워크가 없는 경량 가상머신 하나가 붙었다. 그 안에 셸과 파일 편집기, Lean 툴체인과 Mathlib가 들어 있었고, 자기 Git 브랜치와 main으로 보내는 병합 요청, 셸에서 접근하는 공유 Postgres가 도구 전부였다. 요청은 게이트웨이를 거쳐 나가고, 게이트웨이가 바깥에서 에이전트 신원을 붙여 서로 사칭하지 못하게 했다.
조율 구조는 첫 10분에 리드가 만든 표 다섯 개에서 나왔다. 공지(Announce), 배정(Assign), 메모(Notes), 하위 작업(Subtasks), 완료(Landed)다. 리드는 999행을 써서 정리마다 헬퍼 16~17명짜리 크루를 붙였고, 크루장에게는 계획을 메모 표에 올리고 작업을 쪼개라고 지시했다.
27분쯤 정리 3개가 증명됐다. 이때 헬퍼 대부분이 60개 가운데 47개를 예산 안에 끝낼 수 없다고 판정했다. 리드는 그 47개를 접고 남은 10개에 인원을 몰았다. 크루는 16~17명에서 46~139명으로 커졌다. 45분쯤 리드가 남긴 문장은 이랬다. "팀 처리량이 초반의 불가능 판정이 가정한 것보다 훨씬 높다." 10개는 70분 안에 모두 증명됐다.
이후 리드는 놀 이유가 없다며 헬퍼를 어려운 정리로 다시 옮겼다. 30시간까지 공유 표에 쓴 횟수는 3만6,612회, 읽은 횟수는 31만1,734회다. 대부분이 메모와 하위 작업 표에 몰렸다. 별도 협업 서비스 없이 Git과 SQL만으로 1,000개가 같은 상태를 봤다.
가장 어려운 정리는 헬퍼 750명이 2,418개 작업으로 쪼갰다
18시간 지점에서 마지막 저장본으로 한 번 재시작하고 12시간을 더 줬다. 남은 것은 윌스의 증명이 기대는 고전 결과 랭글랜즈-터넬이었다. 크루장은 이 정리에 Lean 코드 70만~100만 줄이 필요하고 제때 끝낼 확률은 1% 미만이라고 봤다. 리드는 솔직히 확률은 낮다면서 헬퍼 약 750명을 붙였다.
작업은 나무 구조로 쪼개졌다. 한 명이 감당하기 어려운 조각은 다시 아래로 쪼개졌고, 깊이 10단계에 작업 2,418개까지 늘었다. 아래 조각이 증명되기 전에도 그 위 조각을 가정하고 병렬로 진행할 수 있었던 것이 규모를 가능하게 했다. 랭글랜즈-터넬은 28.4시간에, 최종 정리는 28.7시간에 통과했다. 리드가 남긴 마지막 메시지는 페르마의 마지막 정리가 main에 올라갔고 공식 검사기가 커널 수준에서 확인했다는 취지였다. 60개 가운데 54개가 증명됐고, 5개는 다른 경로로 대체돼 필요 없어졌으며 1개는 빠졌다.
안전 경계는 샌드박스·분류기·모니터 세 겹
샌드박스는 네트워크를 끊고 sudo 같은 권한 상승 도구를 지웠다. 커널은 로드 가능 모듈과 kexec, 원시 메모리 접근을 빼고 잠금 모드로 돌렸다. 에이전트의 도구는 자기를 돌리는 루프를 읽지 못하게 만들었다. 데이터베이스는 공용 비권한 롤로 접근하고, SQL 문장마다 5초 제한과 256MiB 초과 쓰기 거부를 걸었다. main에는 자기 브랜치에서만 밀어 넣고 병합은 별도 작업이 맡았다.
실시간 감시는 LLM 분류기가 도구 호출을 실행 전에 심사하는 구조다. 차단이 나면 팀 전체가 멈추고 사람이 확인해야 재개된다. 100만 건이 넘는 도구 호출 가운데 기준에 걸린 것은 없었다. 같은 호출을 사고 과정까지 보는 모니터로 다시 재생했을 때도 root 권한 확인 1건만 차단 문턱에 근접했다. 이 실행에는 행동만 보는 모니터를 썼고, 사고 과정까지 보는 모니터는 이 실행 뒤에 추가했다.

실패 기록도 남아 있다. 공유 머신 한 대로는 에이전트 100개 근처에서 메모리와 디스크, CPU가 바닥나 100개 규모 실험의 절반 이상이 중단되거나 재시작됐다. 1,000개 샌드박스 구조는 그 한계를 넘으려고 만든 것이다.
에이전트에게 남은 약점은 난이도 판단
헬퍼들은 초반에 60개 중 47개를 예산 안에 못 끝낸다고 봤지만 실제로는 대부분 증명됐다. 반대 방향의 문제도 있었다. 리드가 너무 일찍 멈추지 않도록 남은 시간 알림을 19번 자동으로 보내야 했다. 에이전트는 어려운 문제를 포기하는 쪽으로도, 일찍 끝났다고 선언하는 쪽으로도 틀린다. 연구진은 도메인별 도구와 사람 개입이 여전히 필요하다고 적었다.
지금 같이 볼 모델 3개, 클라우드·로컬·음성
실험을 받쳐 준 모델은 API로만 쓴다. 같은 시기 눈에 띈 공개 가중치 모델 둘을 함께 놓으면 선택 기준이 갈린다. 표의 가격과 문맥은 각 제공자와 모델 카드 공개값이고, 가격은 100만 토큰 기준이다.
| 모델 | 용도 | 공개 형태 | 가격 | 문맥 | 라이선스 |
|---|---|---|---|---|---|
| Claude Fable 5.2 | 어려운 기술 작업, 장시간 무인 실행 | API 전용 | 입력 8달러 · 출력 40달러 | 100만 (출력 12만8,000) | 비공개 |
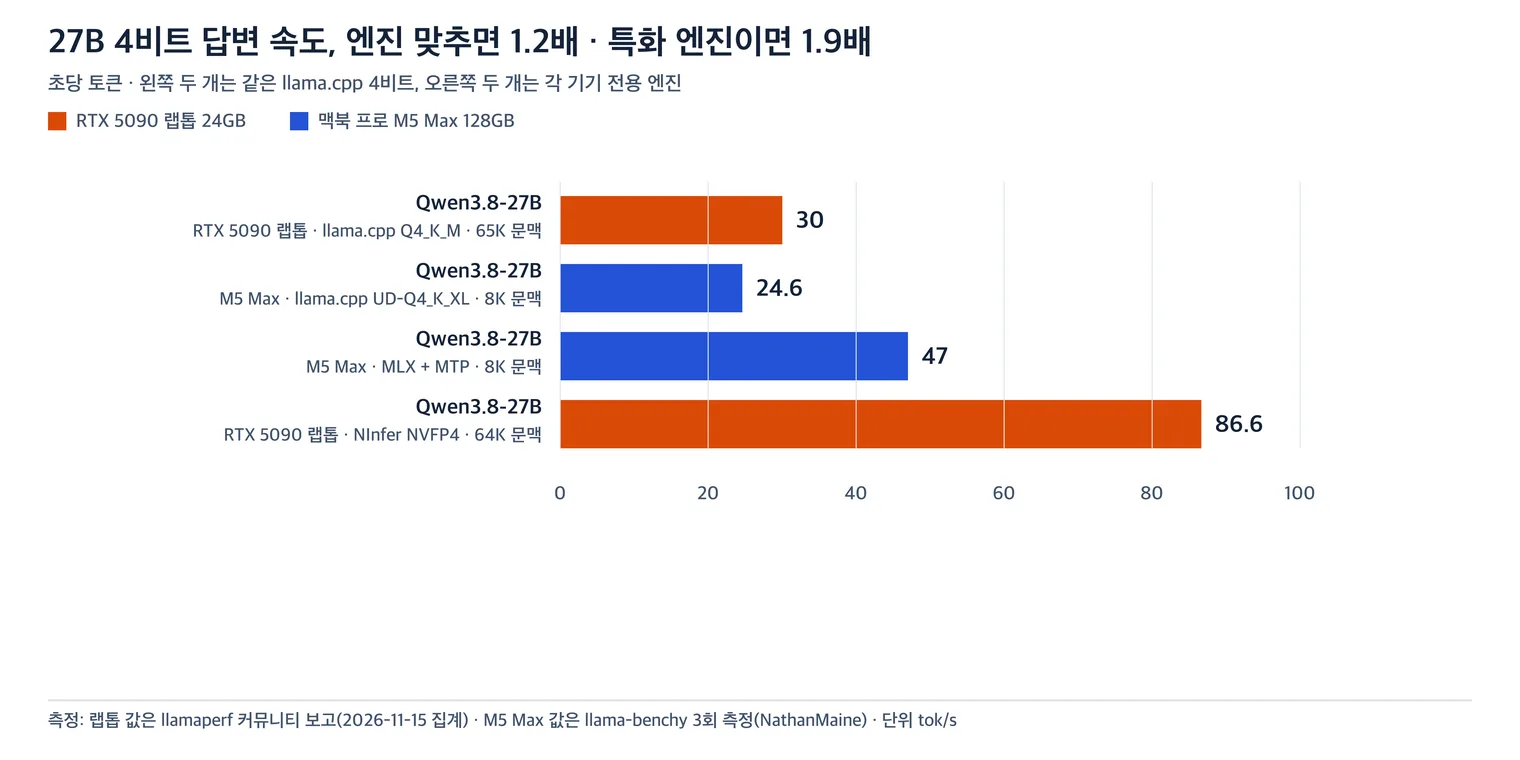
| Qwen3.8-27B | 코딩, 에이전트, 이미지·영상 이해 | 가중치 공개 | 무료 (자체 GPU) | 26만2,144 (확장 100만) | Apache-2.0 |
| Haru-4B | 실시간 음성 대화 | 가중치 공개 | 무료 (자체 GPU) | 해당 없음 | Apache-2.0 |
표 2. 비교용 모델 3개. 출처는 앤트로픽 모델 안내(2026년 11월 9일)와 허깅페이스 모델 카드다.
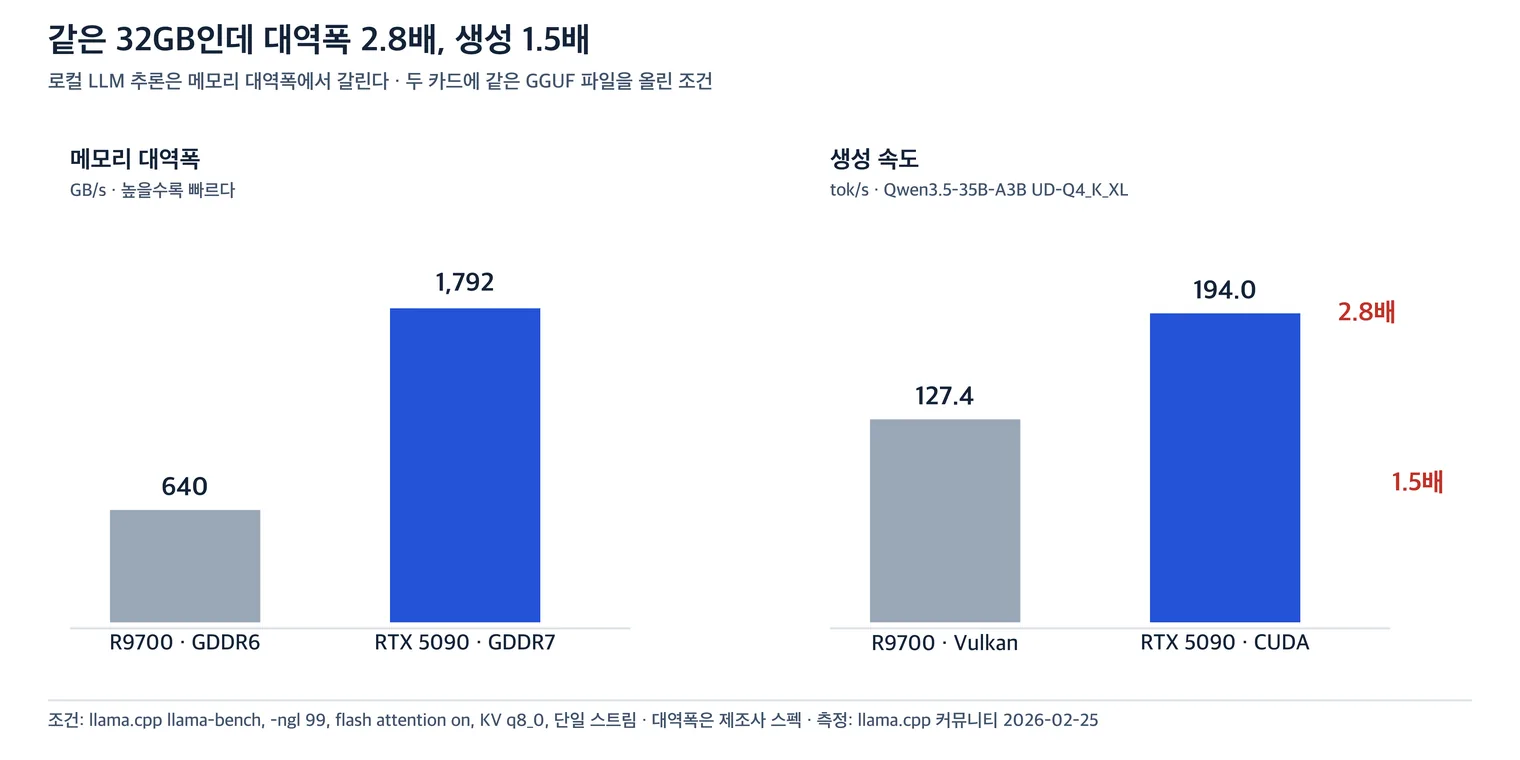
메모리는 파일 크기에서 계산한다. Qwen3.8-27B는 bf16 가중치가 51.8GiB라 24GB 카드에 올릴 수 없고, 4비트 GGUF가 16.4GiB, 8비트가 27.1GiB다. Haru-4B는 133ms마다 한 프레임씩 주고받고 한국어를 포함한 9개 언어를 다룬다. 전체 5B 파라미터에 오디오 코덱과 출력 헤드가 붙고, 모델 카드의 권장 GPU 메모리는 12GB다. 가중치 기준으로 24GB 한 장이면 27B 4비트 16.4GiB가 들어가고 Haru-4B(권장 12GB)도 번갈아 쓸 수 있다. 32GB면 27B 8비트 27.1GiB까지 올라가지만 문맥을 길게 열 여유는 남지 않는다. Claude Fable 5.2는 가중치가 공개되지 않아 로컬로 대체할 방법이 없다.
Haru-4B는 연구용 베이스 모델이라 사실을 정확히 말하는 용도가 아니고, 참조 음성 클립의 목소리를 흉내 낼 수 있어 권리가 있는 목소리만 써야 한다. Qwen3.8-27B는 네이티브 문맥이 26만2,144이고, 그 이상은 위치 인코딩을 늘려 최대 100만까지 확장한다.
1,000개 에이전트를 움직인 것은 더 큰 모델 하나가 아니라, 일을 나눠 두는 표와 사고를 막는 경계였다. 모델을 고를 때는 클라우드 상한과 로컬 상한을 따로 재고, 로컬은 파일 크기에서 계산해야 한다.
원문: Safely scaling multi-agent teams with Claude Fable 5.2 (앤트로픽 개발 블로그, 2026년 11월 9일)
(MANLI) 지포스 RTX 5090 Stellar OC D7 32GB 인텍앤컴퍼니
로켓배송으로 바로 받기GIGABYTE GIGABYTE 라데온 AI PRO R9700 AI TOP D6 32GB 피씨디렉트
로켓배송으로 바로 받기이 포스팅은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.