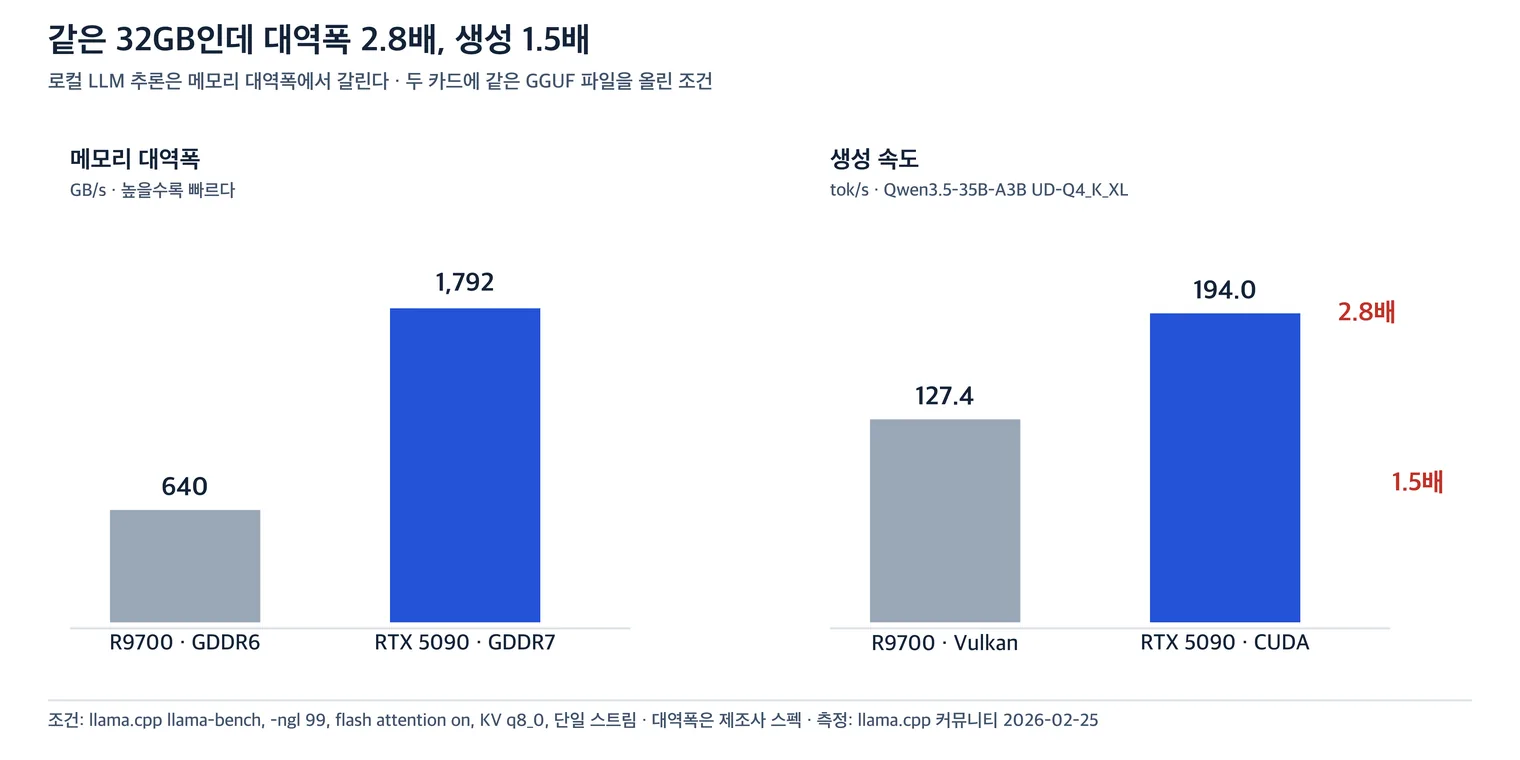
AMD R9700 32GB와 RTX 5090은 메모리 용량이 똑같다. 그런데 같은 모델 파일을 올려 놓고 재면 생성 속도가 약 1.5배, 32K 문맥의 프롬프트 처리에서는 3.4배까지 벌어진다. 권장가는 1,299달러와 1,999달러다.
32GB 한 장에 27B~35B 모델을 올리고 짧은 대화와 요약 위주로 쓴다면 R9700으로 충분하다. 코딩 에이전트처럼 매 턴 긴 문맥을 다시 읽히는 작업이라면 그 대기 시간이 곧 작업 흐름이라 RTX 5090 쪽을 봐야 한다.
두 카드 모두 32GB다. 70B를 4비트로 줄이면 파라미터 700억 개에 0.5바이트씩 붙어 가중치만 35GB 선이라 어느 쪽도 한 장에 들어가지 않는다. 이 급에서 갈리는 것은 용량이 아니라 대역폭과 전력, 그리고 소프트웨어 성숙도다.
AMD R9700 32GB와 RTX 5090 32GB, 스펙에서 갈리는 다섯 줄
| 항목 | Radeon AI PRO R9700 | GeForce RTX 5090 |
|---|---|---|
| 메모리 | 32GB GDDR6, 256비트 | 32GB GDDR7, 512비트 |
| 메모리 대역폭 | 640 GB/s | 1,792 GB/s |
| 전력 | 300W | 575W |
| 권장 파워서플라이 | 750W | 850W |
| 권장가 | 1,299달러 | 1,999달러 |
표의 대역폭과 전력은 AMD와 엔비디아 제품 페이지 값이다. 대역폭이 2.8배 차이 나는데 전력은 575W 대 300W다. 아래 측정값을 카드 전력(TBP)으로 나누면 R9700이 와트당 0.42토큰, RTX 5090이 0.34토큰이 된다. 실제 소비전력은 부하와 카드 설계에 따라 다르므로 효율의 방향을 가늠하는 참고 수치로만 봐야 한다.
AMD 스펙표 기준으로 R9700은 GDDR6에 ECC를 붙일 수 있지만 리눅스에서만 동작한다. RTX 5090은 GDDR7 512비트로 대역폭을 밀어붙이는 대신 575W를 쓰고 850W 파워를 요구한다.

같은 파일로 재면 생성 1.5배, 프롬프트는 2.6~3.4배
조건을 먼저 적는다. Qwen3.5-35B-A3B UD-Q4_K_XL 약 19GB, llama.cpp llama-bench, 모든 레이어를 GPU에 올리고(-ngl 99), 플래시 어텐션을 켜고, KV 캐시는 q8_0, 단일 스트림이다. R9700은 Vulkan, RTX 5090은 CUDA로 돌렸다.
| 구분 | R9700 (Vulkan) | RTX 5090 (CUDA) | 차이 |
|---|---|---|---|
| 생성 | 127.4 tok/s | 194.0 tok/s | 1.52배 |
| 프롬프트 512 | 2,713 tok/s | 7,026 tok/s | 2.59배 |
| 프롬프트 8,192 | 2,413 tok/s | 6,835 tok/s | 2.83배 |
| 프롬프트 32,768 | 1,877 tok/s | 6,461 tok/s | 3.44배 |
32,768토큰짜리 프롬프트 하나를 처리하는 시간으로 바꾸면 R9700이 17.5초, RTX 5090이 5.1초다. 한 번 묻고 끝나는 질문에서는 차이가 작다. 문제는 대화가 길어질수록 벌어진다는 점이다.
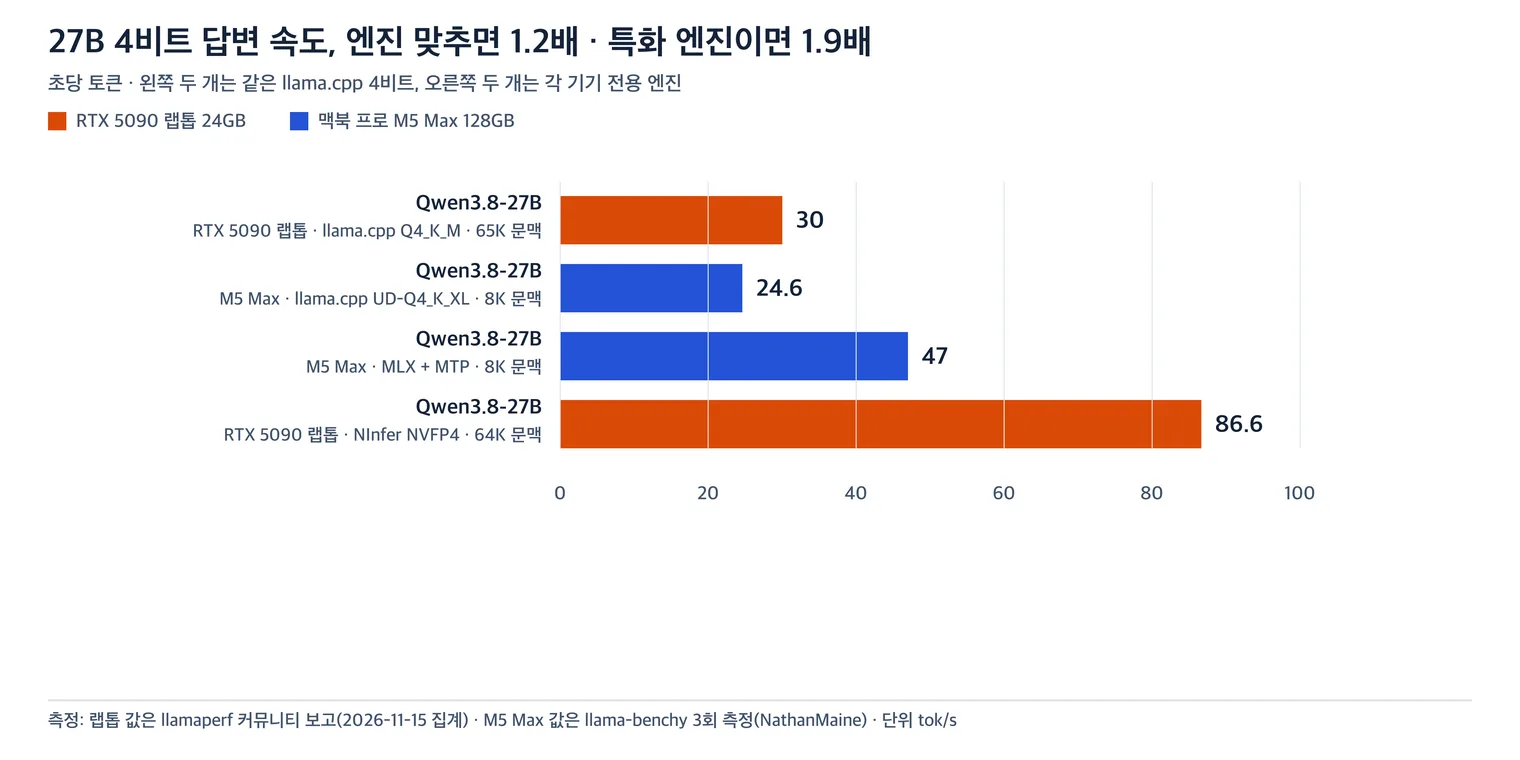
생성 격차가 대역폭 격차보다 작은 이유는 이 모델이 MoE이기 때문이다. 35B 가운데 토큰마다 읽는 가중치가 3B 수준인 MoE라 대역폭 의존이 낮은 것으로 보인다. 가중치를 매 토큰마다 다 읽는 dense 모델 실측에서는 격차가 3.1배로 더 벌어졌다. Qwen3.8-27B IQ4_XS 17.03GB를 262K 문맥에 올리고 투기적 디코딩을 켠 해외 업체 공개 실측에서 R9700은 41~45토큰, RTX 5090은 120~146토큰으로 3.1배였다.
다만 이 측정은 R9700을 ROCm으로 돌렸고 투기적 디코딩 깊이도 3과 4로 달랐다. 배수만 보지 말고 조건까지 함께 읽어야 하는 이유다.
차이는 소프트웨어에서 한 번 더 벌어진다
R9700은 ROCm 10.1 호환성 매트릭스에 gfx1201로 등재돼 있다. 리눅스와 윈도 모두 공식 지원 목록에 있고 PyTorch 2.14와 vLLM 0.29도 같은 표에 올라 있다. 드라이버를 직접 고쳐야 했던 예전 AMD 카드와는 단계가 다르다.
그래도 백엔드 선택이 성능을 흔든다. 같은 R9700에서 Qwen3-30B-A3B Q4_K_M을 돌린 커뮤니티 측정은 Vulkan 183토큰, ROCm 150토큰이었다. 어느 쪽을 잡느냐에 따라 20% 넘게 차이 난다. RTX 5090은 CUDA 한 갈래라 이 고민이 없다.
PCIe 레인도 변수다. 같은 카드가 x16 슬롯에서 85토큰, 칩셋을 거치는 x4 슬롯에서 67토큰으로 떨어졌다는 사용자 보고가 있다. 카드 한 장 값을 아끼려고 슬롯 구성이 빈약한 보드를 고르면 그 차액이 속도로 돌아온다.
AMD R9700 32GB를 사도 되는 경우와 피해야 하는 경우
한 장에 27B~35B 모델을 올리고 짧은 질문과 요약 위주로 쓴다면 R9700이 맞다. 짧은 대화에서는 두 카드 차이가 1.52배이고, 값은 R9700이 3분의 2 수준이다. 이 작업에서는 R9700이 합리적인 선택이다.
코딩 에이전트, 긴 문서 요약, 검색 증강 생성처럼 문맥을 매 턴 다시 읽는 작업은 RTX 5090이다. 32K 문맥에서 17.5초와 5.1초 차이는 하루 수백 번 쌓이면 체감이 아니라 작업을 끊는 시간이 된다.
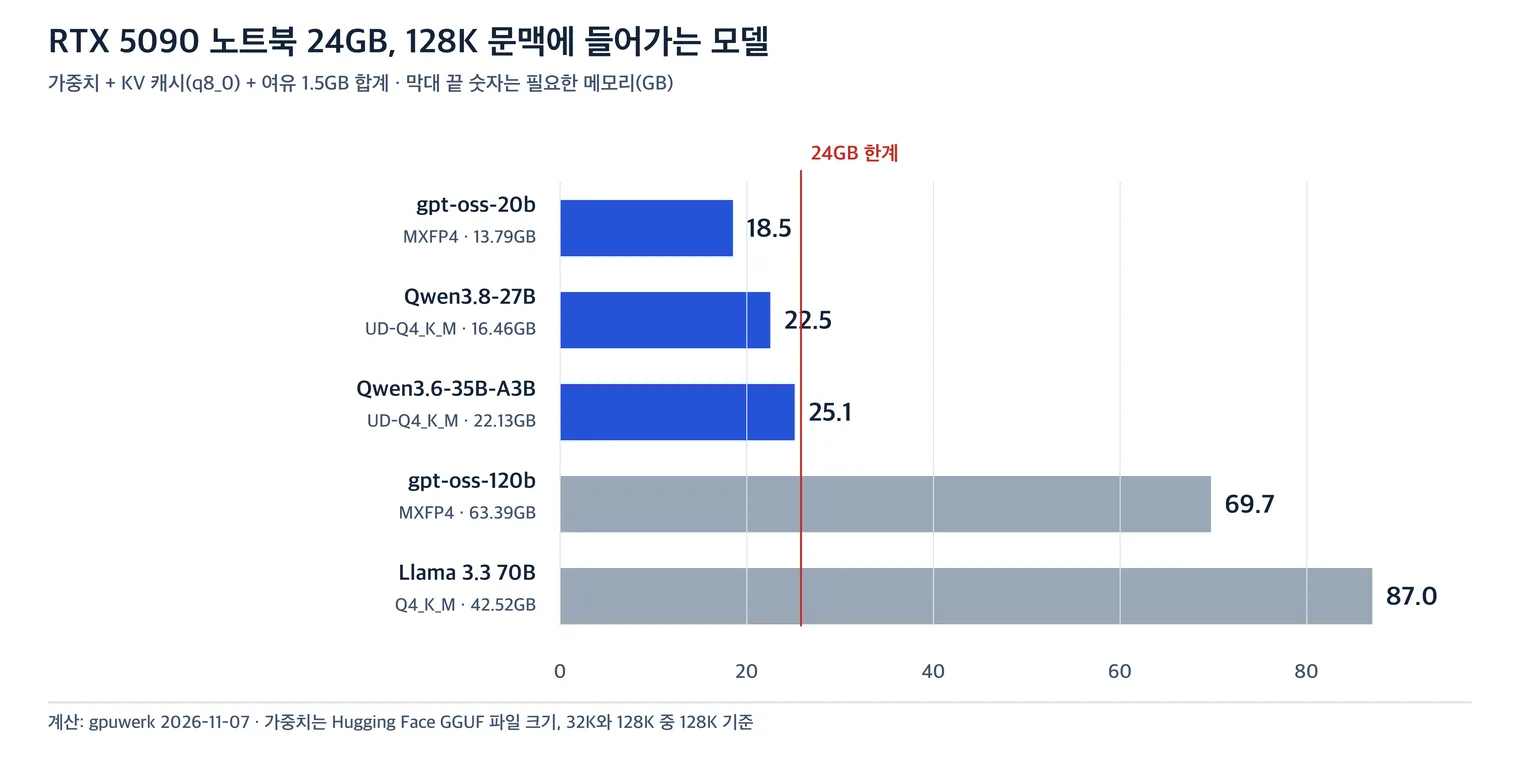
두 장으로 64GB를 만들 계획이라면 계산이 갈린다. 권장가로는 2장이 2,598달러로 RTX 5090 한 장 값보다 비싸다. 반대로 시장가가 권장가에서 크게 벌어진 지금은 2장이 5090 한 장보다 싸게 잡히는 시장도 있다. 2026년 2월 폴란드 시장에서 5090은 약 4,300달러, R9700은 약 1,600달러에 거래됐다. 다만 카드마다 300W가 붙고, 35GB짜리 70B 4비트를 64GB 두 장에 올리면 남는 문맥 캐시 여유는 29GB다.

한 줄 정리
32GB라는 숫자가 같다고 같은 카드가 아니다. 모델이 들어가는지만 보면 R9700, 문맥을 얼마나 자주 다시 읽히는지를 보면 RTX 5090이다. 이 두 카드에서는 용량이 아니라 대역폭과 백엔드가 값을 갈랐다.
근거: llama.cpp 커뮤니티 llama-bench 비교 · Phoronix R9700 리뷰 · ROCm 10.1 호환성 매트릭스 · AMD R9700 제품 페이지 · 27B 밀집 모델 측정
GIGABYTE 라데온 AI PRO R9700 AI TOP D6 32GB 피씨디렉트
로켓배송으로 바로 받기(MANLI) 지포스 RTX 5090 Stellar OC D7 32GB 인텍앤컴퍼니
로켓배송으로 바로 받기이 포스팅은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.