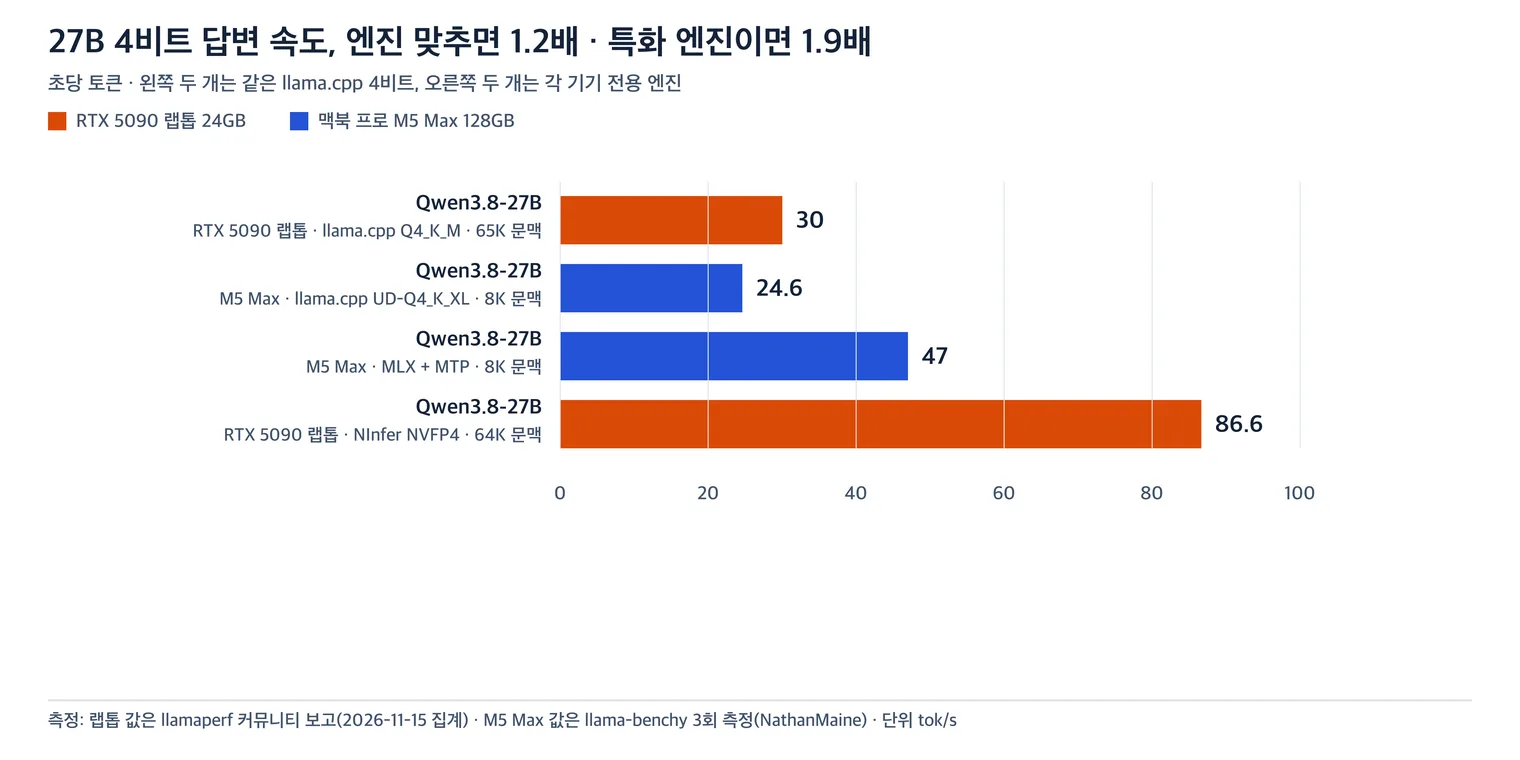
RTX 5090 노트북의 24GB 메모리로 Qwen3.8-27B를 NVFP4로 돌리면 llama.cpp에서 초당 39.3토큰이 나온다. 같은 카드에서 vLLM으로 AutoRound INT4 체크포인트에 MTP n=3을 붙이면(75K 문맥) 85~100토큰까지 올라간다. 70B와 gpt-oss-120b는 24GB에 올릴 수 없다.
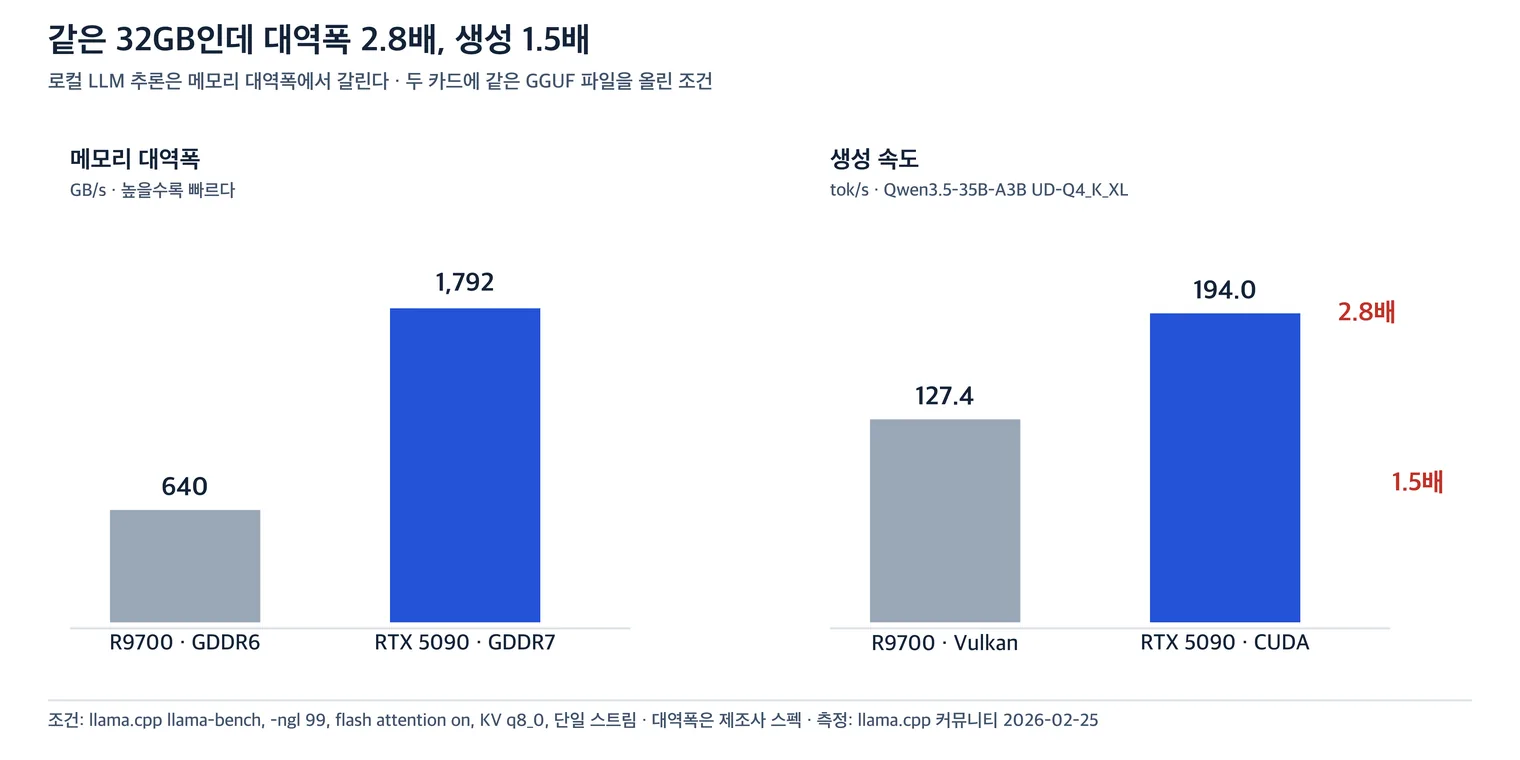
이 카드는 GDDR7 24GB를 256비트로 묶어 896GB/s를 낸다. 데스크톱 RTX 5090의 1,792GB/s와 비교하면 정확히 절반이고, 전력은 기본 95~150W이고, 다이내믹 부스트를 켜면 최대 175W다. 10,496개 CUDA 코어는 데스크톱 RTX 5080과 같은 GB203 칩에서 256개를 덜어낸 수치다.
데스크톱의 절반, 대역폭이 그 절반을 만든다
llama.cpp 공개 스코어보드의 Llama 2 7B Q4_0 기록을 나란히 놓으면 비율이 깔끔하게 떨어진다. 175W 모드가 초당 158.1토큰, 95W 모드가 117.2토큰, 데스크톱 RTX 5090이 300.4토큰이다. 프롬프트 처리도 7,642토큰과 5,008토큰, 14,970토큰으로 갈린다. 생성 53%, 프롬프트 51%, 대역폭 50%로 세 비율이 거의 같다.
| 항목 | RTX 5090 노트북 | 데스크톱 RTX 5090 |
|---|---|---|
| 칩 | GB203, CUDA 10,496개 | GB202, CUDA 21,760개 |
| 메모리 | 24GB GDDR7, 256비트 | 32GB GDDR7, 512비트 |
| 대역폭 | 896GB/s | 1,792GB/s |
| 전력 | 기본 95~150W, 부스트 최대 175W | 575W |
| Llama 2 7B Q4_0 생성 | 158.1토큰(175W) | 300.4토큰 |
| 같은 모델 프롬프트 | 7,642토큰(pp512) | 14,970토큰 |
같은 카드라도 기록마다 값이 조금씩 다르다. HP 오멘 맥스 16에서 140~160W로 돌린 기록은 164.3토큰이었고, 스코어보드의 175W 모드 기록은 158.1토큰이었다. 전력이 낮은 쪽이 더 빨랐던 것은 운영체제와 빌드, 측정 조건이 달랐던 탓으로 보인다. 다른 사람의 토큰 수와 내 것을 비교하려면 전원과 성능 프로파일, 빌드까지 맞춰야 한다.
전력 모드를 낮추면 생성 26%, 프롬프트 34%가 사라진다
같은 노트북을 95W 모드로 내리면 7B 생성이 158.1토큰에서 117.2토큰으로 26% 줄고, 프롬프트 처리는 7,642토큰에서 5,008토큰으로 34% 줄어든다. 프롬프트는 연산이라 클럭을 따라가지만, 생성은 메모리를 읽으며 기다리는 일이라 덜 떨어진다. 이 기록에서는 95W와 175W 차이가 생성 속도 26%를 갈랐다.
열은 생각보다 여유가 있었다. HP 오멘 맥스 16이 175W 한도에서 167W를 쓰며 82도를 찍은 기록이 있는데, 그 기록에서는 목표 온도 87도 아래였고 열 스로틀링 시간이 0이었다. 대신 그 사용자가 만난 문제는 CUDA 그래프가 멈추는 버그였고, GGML_CUDA_DISABLE_GRAPHS=1을 걸어 우회했다. 긴 세션이 멈추는 증상이 나오면 이 사례처럼 GGML_CUDA_DISABLE_GRAPHS=1을 먼저 시도한다.

RTX 5090 노트북 24GB에 들어가는 모델
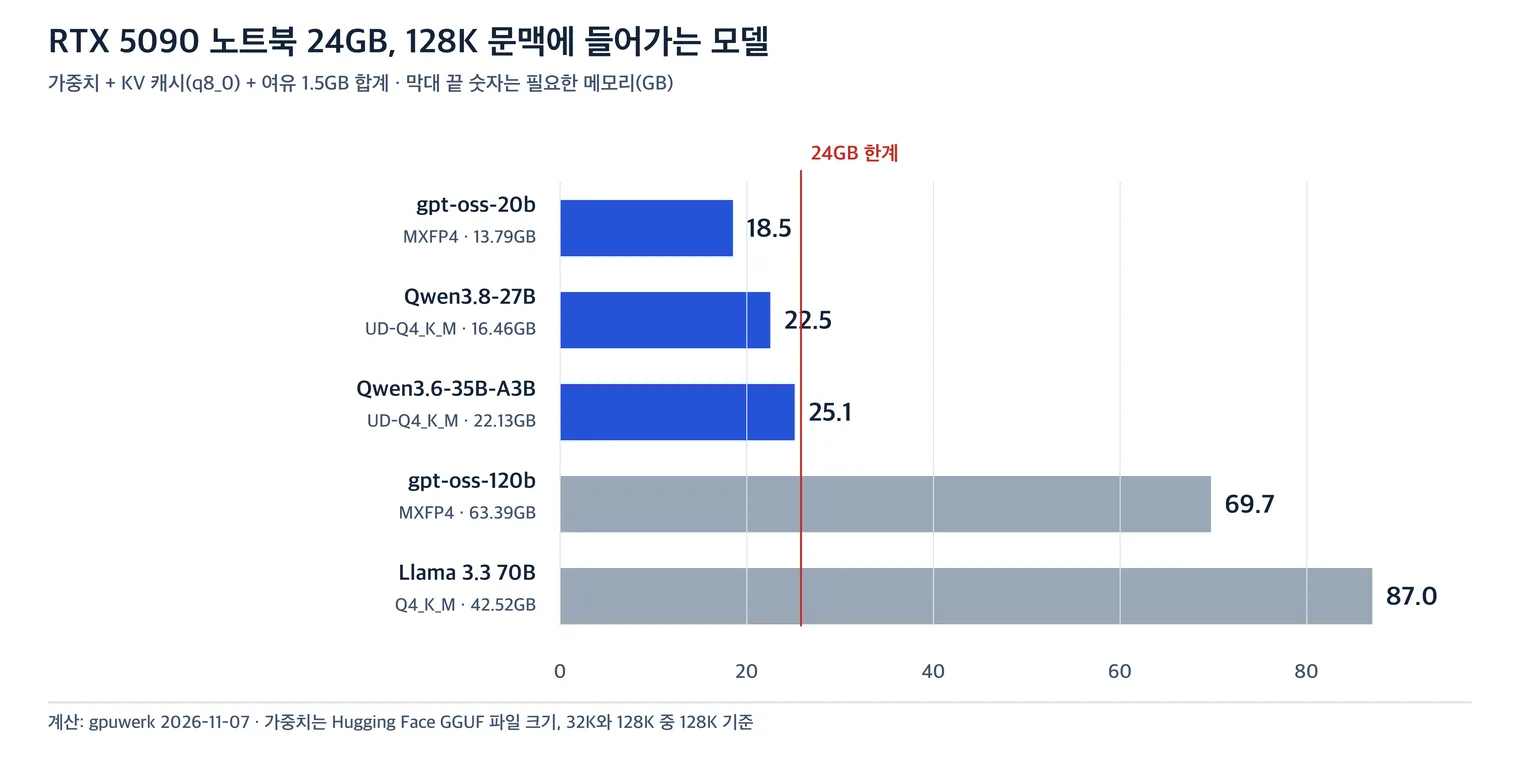
4비트 양자화 기준으로 27B는 여유가 있고 35B는 아슬아슬하다. 가중치 파일 크기에 문맥 캐시와 여유 1.5GB를 더해 24GB(25.77GB)와 비교하면 경계가 분명해진다. 128K 문맥을 쓰려면 KV 캐시를 q8_0으로 줄여야 하고, 그래도 35B는 아슬아슬하다.
| 모델 | 양자화 | 가중치 | 32K 필요 | 128K 필요 | 판정 |
|---|---|---|---|---|---|
| gpt-oss-20b | MXFP4 | 13.79GB | 16.1GB | 18.5GB | 가능 |
| Qwen3.8-27B | UD-Q4_K_M | 16.46GB | 20.1GB | 22.5GB | 가능 |
| Qwen3.6-35B-A3B | UD-Q4_K_M | 22.13GB | 24.3GB | 25.1GB | 아슬 |
| Qwen3-32B | Q4_K_M | 19.76GB | 29.9GB | 문맥 40K가 한계 | 짧은 문맥만 |
| Llama 3.3 70B | Q4_K_M | 42.52GB | 54.8GB | 87.0GB | 불가 |
| gpt-oss-120b | MXFP4 | 63.39GB | 66.1GB | 69.7GB | 불가 |
35B-A3B처럼 전문가를 나눠 쓰는 MoE 모델은 전문가를 시스템 램에 두고 돌리는 방법도 있다. 이때 초당 30토큰 안팎이 나오지만 빠른 시스템 램이 필수이고, 5090 노트북 최저가 모델은 램이 16GB에 그친다. 24GB에 안 들어가는 모델을 억지로 끌어오는 것보다 27B나 35B를 제대로 돌리는 편이 낫다.
추측 디코딩을 켜면 24GB에서도 100토큰
24GB에서 27B를 돌리면 대역폭만으로는 NVFP4 15.5GB를 896GB/s로 나눈 단순 계산으로는 초당 57.8토큰이 상한이고, 출처 작성자는 실제 효율을 감안해 약 50토큰으로 추정했다. llama.cpp 실측 39.3토큰은 단순 계산값의 68%다. 이 천장을 넘는 방법이 추측 디코딩이다. 작은 예측 머리가 다음 토큰 몇 개를 먼저 찍고, 큰 모델이 한 번에 검사해 맞는 것만 남긴다. MTP라는 이름으로 모델에 붙어 오는 기능이 이 역할을 한다.
llama.cpp에서는 같은 카드에서 Qwen3.8-27B NVFP4가 39.3토큰, MTP를 켠 공식 빌드 기록이 50.3토큰이다. 둘 다 152K 문맥에 KV q8_0이지만 빌드가 달라 MTP만의 효과로 보기는 어렵다. 대신 프롬프트 처리가 1,868토큰에서 1,345토큰으로 줄었다. MTP가 프롬프트 처리를 수십 배 느리게 만든 자기 빌드 사례도 보고됐으니, 켜기 전에 두 값을 함께 재야 한다.
vLLM으로 옮기면 폭이 더 벌어진다. NVFP4 체크포인트에 MTP를 붙이면 헤드용 2.37GiB를 새로 잡다가 24GB에서 메모리 부족으로 멈춘다. MTP 헤드를 이미 풀어둔 AutoRound INT4 체크포인트로 바꾸고 KV를 fp8로 두면 n=1에서 65토큰, n=3에서 85~100토큰이 나온다. 최고 99.7토큰, 문맥 75K, 예측 수용률 92~95% 조건이다.
같은 레시피(n=3)를 데스크톱 RTX 5090 32GB에 적용한 참조값은 78~80토큰이었다. n=3 추측 디코딩 조건에서는 노트북이 데스크톱 참조값보다 앞선 사례다. 대역폭이 절반이라 천장은 낮지만, 수용률이 높은 구간에서는 예측 길이가 그 차이를 메운다. 대신 창작 문장처럼 예측이 잘 안 맞는 글은 65~70토큰으로 떨어지고, 정형화된 코드나 표 출력은 95토큰 위로 올라간다.

값: 지금은 노트북이 카드 한 장보다 싸다
유럽 가격 비교에서 RTX 5090 노트북이 3,509유로부터 시작하는데, 데스크톱 RTX 5090 카드 한 장이 6,249유로부터다. 노트북 쪽이 카드 한 장보다 싸다. 국내 판매가는 HP 오멘 맥스 16 RTX 5090이 684만원, 기가바이트 어로스 마스터 16 RTX 5090이 677만원, 레노버 리전 프로7 16IAX10 RTX 5090이 919만원이다.
용량으로 비교하면 결론이 갈린다. 128GB 통합 메모리를 쓰는 MacBook Pro M5 Max는 6,818유로부터이고, 70B나 120B를 문맥 넉넉히 돌리려면 그쪽이 필요하다. 27B 이하 코딩과 에이전트 작업이면 24GB 노트북으로 충분하고, 그 선을 넘는 모델은 24GB에서 아예 시작하지 않는 편이 낫다. 오래 들고 다니며 쓰는 기기라면 전력 프로파일과 시스템 램까지 함께 보고 고른다.
HP 2026 하이퍼엑스 오멘 맥스 16 코어 Ultra9 인텔 14세대 지포스 RTX 5090
로켓배송으로 바로 받기이 포스팅은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.